说明:这篇 blog 在 AI 的辅助下完成。
用多指灵巧手完成手内重定向、工具使用、紧配合装配这类任务,目前最主流的做法是在大规模并行仿真里做强化学习,再迁移到真机。这里讨论的大多数工作,底座都是同一个算法:PPO,配一个对角高斯策略,从任务默认的初始状态开始采样。但只用这个底座,很多灵巧任务都学不会。本文想回答一个问题:为了让灵巧手的 RL 能学起来,近几年的工作在 PPO 之上分别加了什么,各自出于什么动机。
先看普通 PPO 在哪里失败,再按“改动作用在 RL 问题的哪个部分”把这些方法分成六类。
1 问题设定
考虑一个马尔可夫决策过程 $(\mathcal S,\mathcal A,P,r,\rho_0,\gamma)$,以及可选的目标 $g$。策略 $\pi_\theta(a\mid s,g)=\mathcal N(\mu_\theta(s,g),\operatorname{diag}(\sigma^2))$ 输出机械臂和手的关节目标。$\rho_0$ 是初始状态分布,P 是仿真器给出的转移。先略去 PPO 的 clipping 和重要性比率,它使用的策略梯度信号可以近似写成
其中 $\hat A_t$ 是由奖励 r 估计出的优势值。后文的每一类方法,都对应改动这个式子里的一个部分:$\rho_0$、g 的分布、策略的噪声分布、奖励 r,或者转移 P。
本文把灵巧手系统的两条性质当作前提,不做讨论:
- 动作空间高维。 一只手有 16–22 个主动关节,装在 7 自由度的臂上,就是 23–29 维动作;双臂双手超过 50 维。
- 可以借用人类先验。 灵巧手的形态接近人手,所以人类的手部数据,包括动作捕捉、手-物交互视频、手部姿态数据集,在经过重定向之后可以作为先验使用。
2 普通 PPO 为什么不够
文献中报告的失败可以归成四种,它们互相关联,但对应的补救方式不同。
2.1 成功信号几乎为零
灵巧操作的成功区域很窄:抓稳一个物体,需要协调多根手指的接触,并保持受力平衡;转动或插入,还要求物体位姿落在毫米级的容差内。从默认初始状态出发,用高斯噪声扰动一个随机初始化的策略,轨迹进入这个区域的概率接近零。如果一批轨迹在稀疏成功奖励下全部失败,就很难得到指向成功的有效优势信号。DAPG 在 Adroit 上观察到,稀疏奖励下随机探索“从未遇到成功”(手内任务除外);DemoStart 的插头插入任务里,原始 RL 的成功率是 0%。
2.2 稠密奖励带来的局部最优
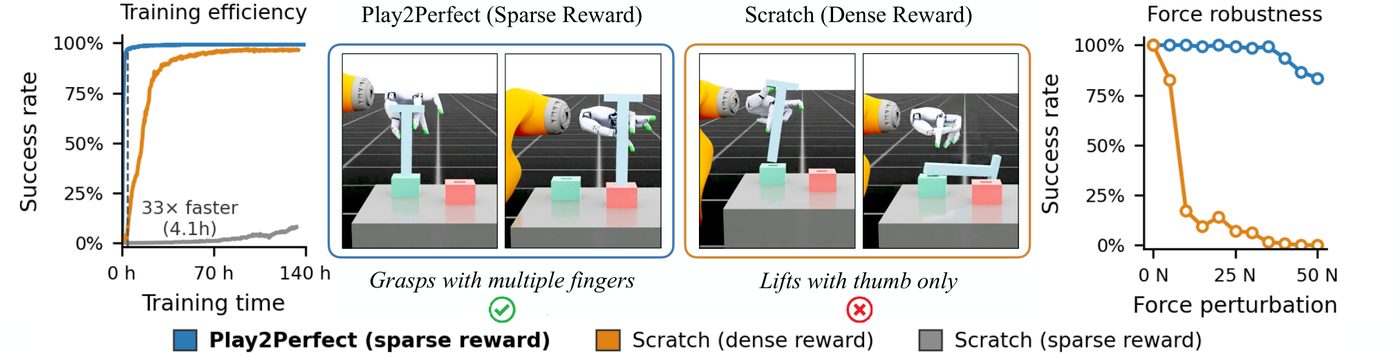
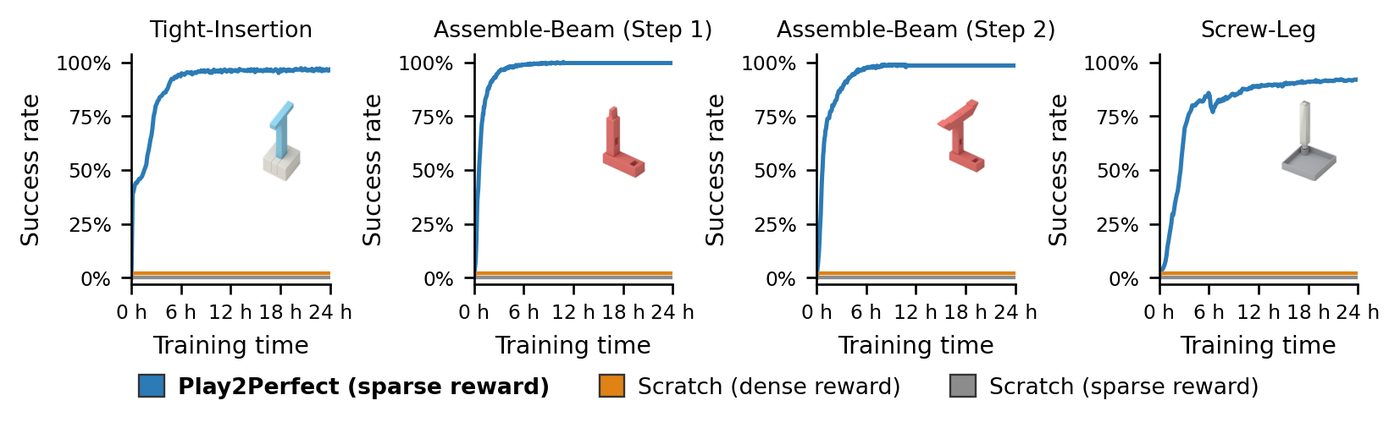
为了绕开 2.1,最直接的做法是加稠密的塑形奖励:手离物体的距离、物体抬起的高度、物体到目标的距离。但在高维、接触丰富的系统里,这类奖励有很多“便宜”的局部解。OmniReset 观察到策略只学会了伸手;Play2Perfect 发现,从零训练的稠密奖励策略学会了让物体在手指上保持平衡,而不是真正抓住它,受到外力推动时立刻失效(图 1);Twisting Lids 中,不带接触提示的步态奖励导致手指动作杂乱。也就是说,稠密奖励把“没有信号”换成了“信号指向错误的解”。
2.3 独立关节噪声的探索效率很低
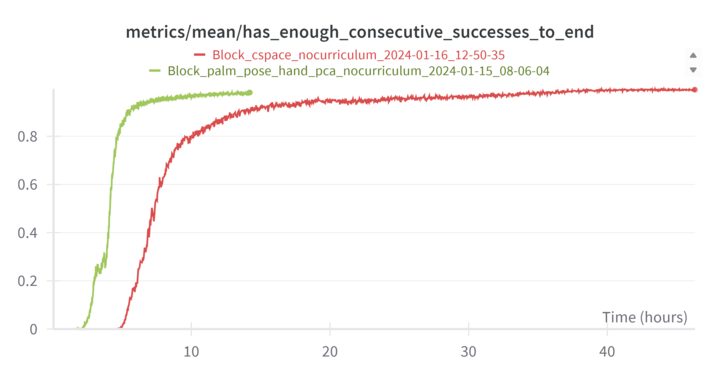
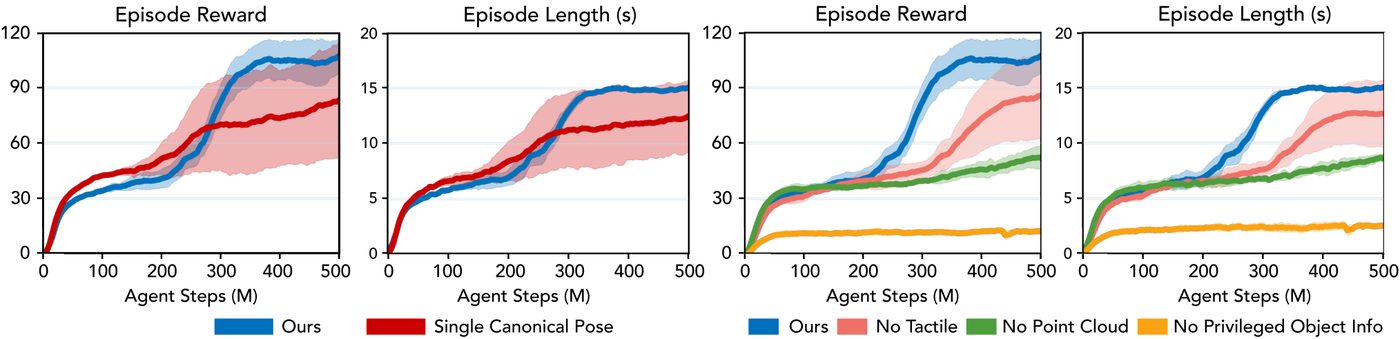
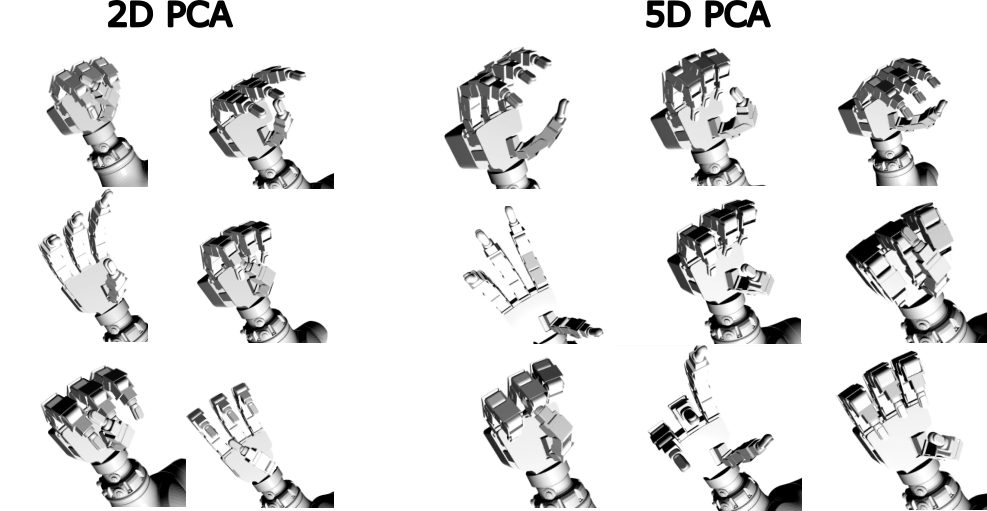
对角高斯策略在每个关节上独立加噪声。人手的姿态高度相关,少数几个主成分就能解释大部分方差:DextrAH-G 用 DexYCB 数据得到,前 5 个主成分解释了 98% 的方差。在 20 多个关节上独立抖动,大部分扰动落在人手几乎不会出现的姿态上,或者彼此抵消。DextrAH-G 直接在关节空间训练时,策略出现了用无名指和中指夹物体之类的怪异抓法,收敛也明显更慢(图 2)。HOP 报告,用关节位置作为动作空间时,从零训练的 PPO 基线始终失败。
2.4 增加环境数的收益递减
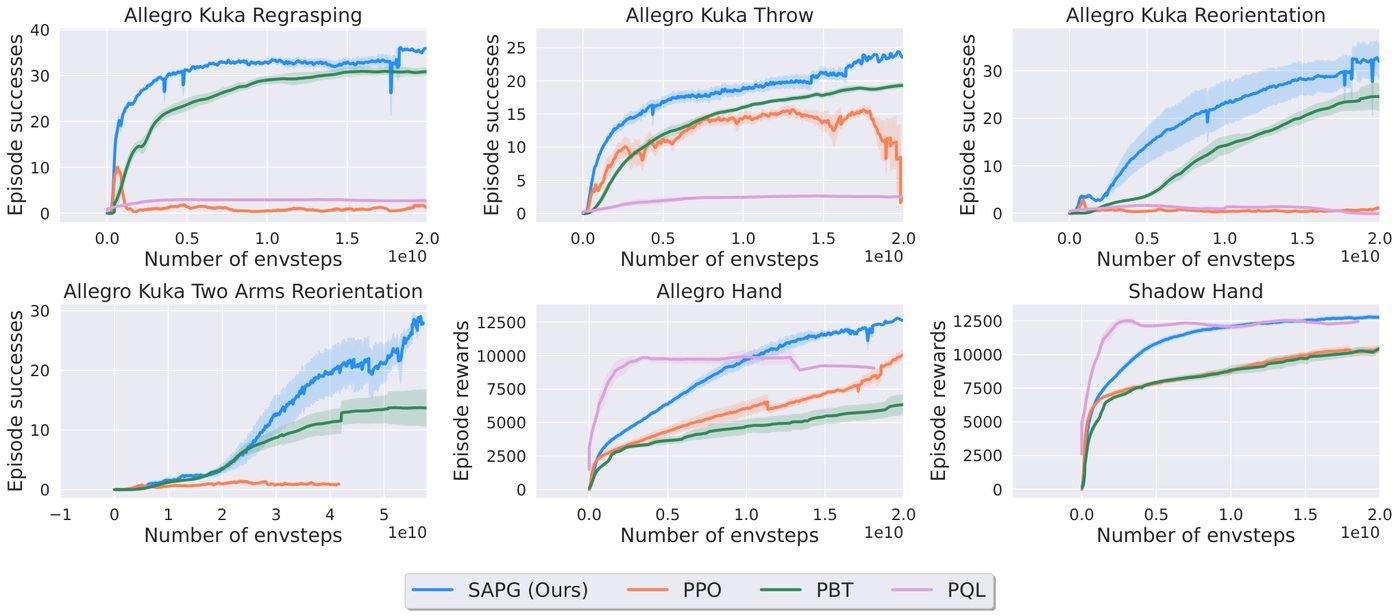
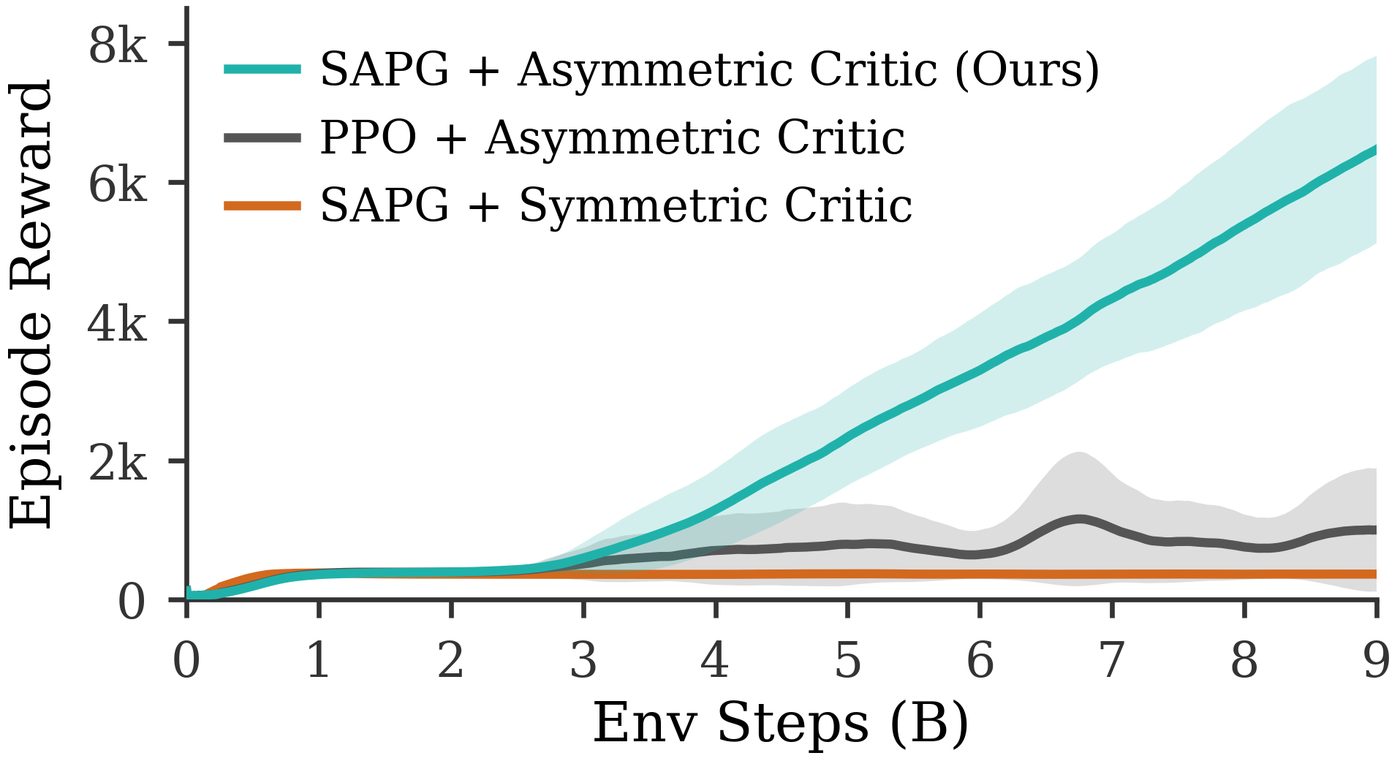
GPU 并行仿真让单卡同时跑上万个环境,但这些环境都从同一个高斯策略采样,数据高度冗余。SAPG 在 AllegroKuka 系列任务上发现,PPO 的性能在环境数增大后很快饱和,双臂重定向任务几乎没有进展(图 3)。DexPBT 报告了另一个现象:独立 PPO 种子之间的差异极大,8 个种子中没有一个能把重定向的精度收紧到 1 cm。
这四种失败对应了后面几类方法的出发点:2.1 和 2.2 推动了起点、目标、跟踪和接触先验方面的工作;2.3 推动了结构化探索;2.4 推动了种群式训练。
3 解决方案
3.1 改起点分布
第一类方法不改任务本身,只改回合从哪里开始。如果训练的初始状态里包含“已经抓住”“已经对准”“离目标很近”这样的状态,那么一部分回合在很短的时间内就能拿到成功奖励,2.1 的问题就能得到缓解。策略会先在接近目标的状态上学会最后几步,再逐渐把能力向前延伸,相当于自动生成了一个从后往前的课程。
在通常的折扣 MDP 假设下,不受函数类限制的策略可以对所有状态同时最优。因此,改变 $\rho_0$ 不必改变这个逐状态最优的策略,改变的是训练样本在状态空间上的分配。实践中,函数逼近和有限样本仍然会让策略在欠采样的区域变差,所以通常会在混合分布里保留一部分默认初始状态。
它的代价是需要能够生成合法的中间状态。对平行夹爪,可以先采样抓取位姿再用 IK 求解;对多指手,要生成多根手指同时稳定接触的状态就困难得多。下面几篇工作的差别,主要就在中间状态从哪里来,以及怎么在其中挑选。
OmniReset [ICLR'26]
Emergent Dexterity via Diverse Resets and Large-Scale Reinforcement Learning · arXiv · Project · Code
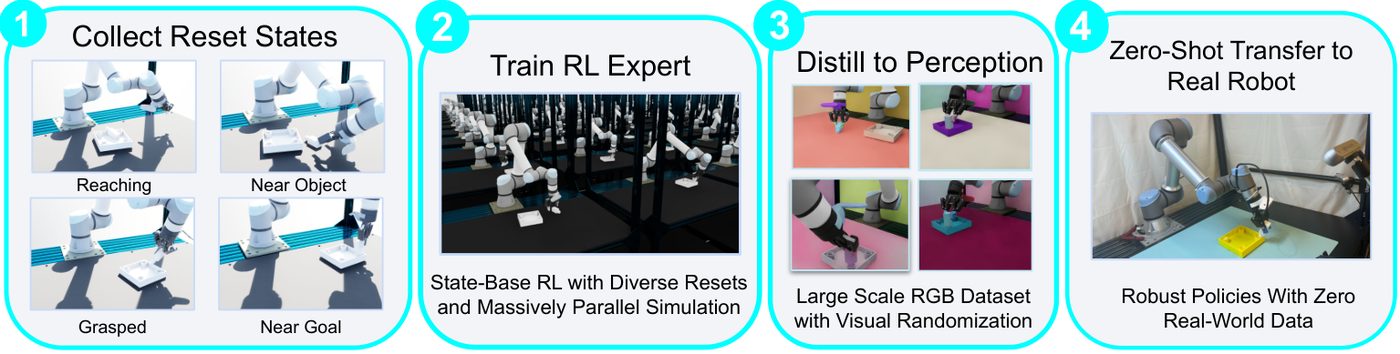
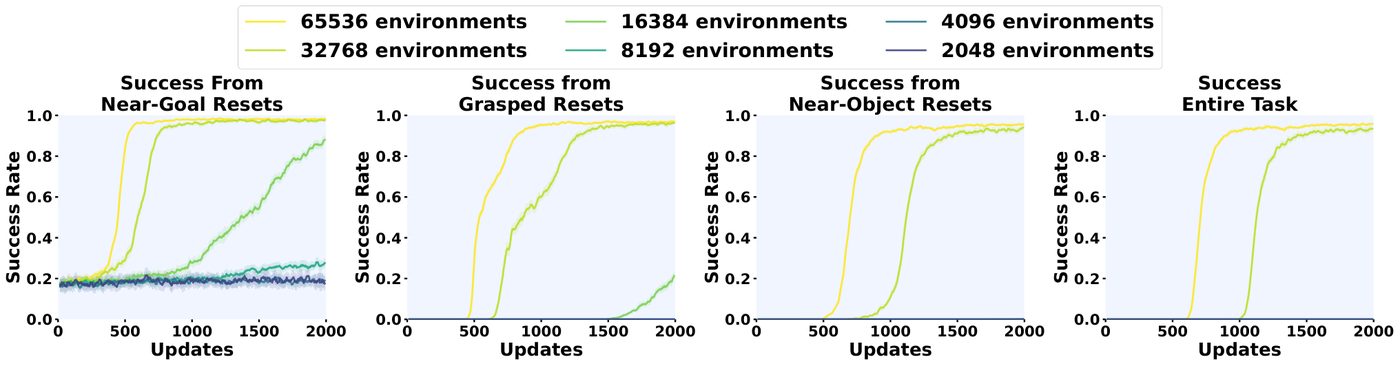
OmniReset 离线生成四类起点:机械臂随机姿态、靠近物体、在空中稳定抓住物体、靠近目标。每类都在仿真里验证过,训练时均匀混合。所有任务共用同一套奖励和超参,不使用课程,也不使用示范。在销钉插入、桌腿拧入、抽屉插入三个任务上,从状态输入训练的仿真成功率分别为 95.0%、93.9%、89.6%;蒸馏成 RGB 策略后,真机成功率分别为 85%、56% 和 15%,而用 100 条示范训练的行为克隆约为 2%。作者的消融显示:环境数越多越好,环境数不足时,策略只能从“靠近目标”的起点学会任务(图 4b);抓取越多样越好;奖励权重几乎没有影响。需要注意,OmniReset 用的是平行夹爪,不是灵巧手。
核心观点
在这组实验中,起点覆盖得足够广时,奖励调参就不那么重要,问题就变成了怎样生成足够多样的中间状态。这一步对夹爪很便宜,对多指手不便宜。
DemoStart [ICRA'25]
DemoStart: Demonstration-led auto-curriculum applied to sim-to-real with multi-fingered robots · arXiv · Project
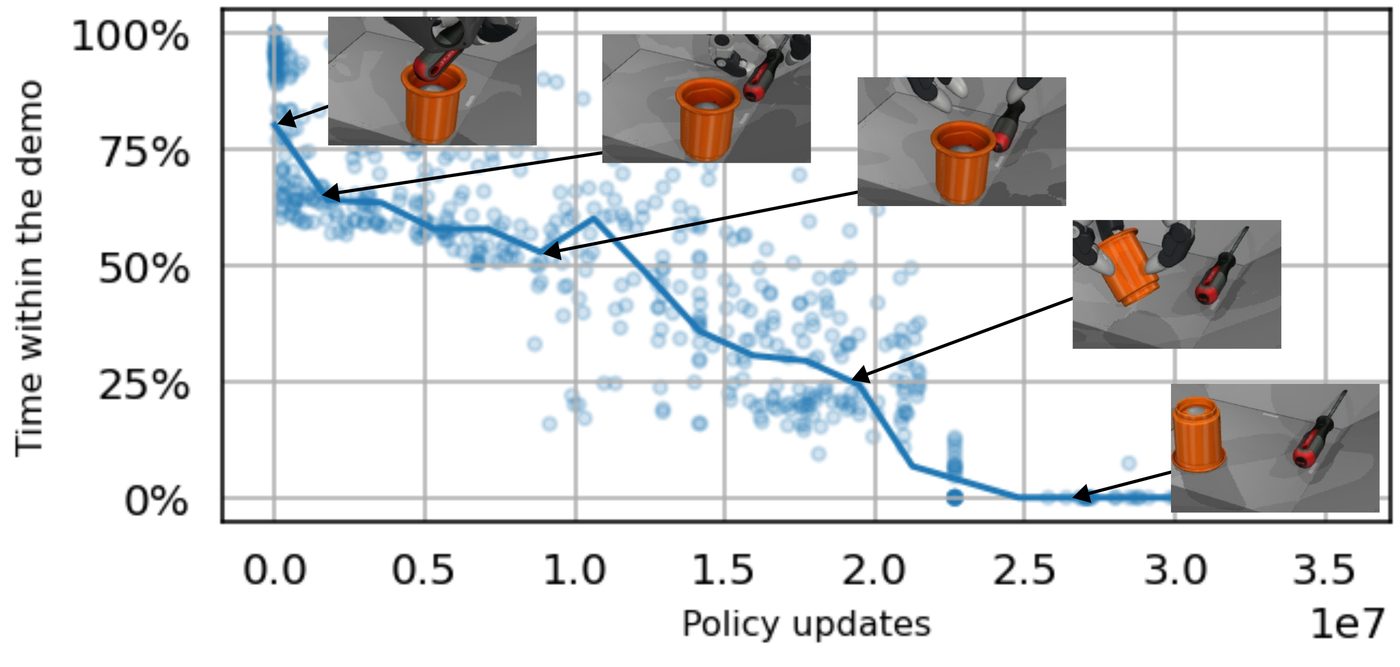
DemoStart 用的是三指手。它从 2–60 条仿真示范中取出完整的仿真状态作为起点,并加了一个零方差过滤:一个起点只有在多次尝试中“有时成功、有时失败”时才保留。插头插入任务上的消融非常清楚:原始 RL 0%;只用示范状态作起点仍是 0%;只保留“曾经成功过”的起点还是 0%;换成零方差过滤后是 97.2%。训练过程中,被选中的起点从示范末尾逐渐移向开头(图 5)。
核心观点
有起点还不够,还要能从这些起点观察到成功与失败的差别。在这里的稀疏奖励设定下,始终成功或始终失败的起点很难提供这样的学习信号。
SGS [CoRL'26]
A Balanced Data Diet: Addressing the Exploration Bottleneck in Mega-Scale RL for Robot Control · arXiv · Project
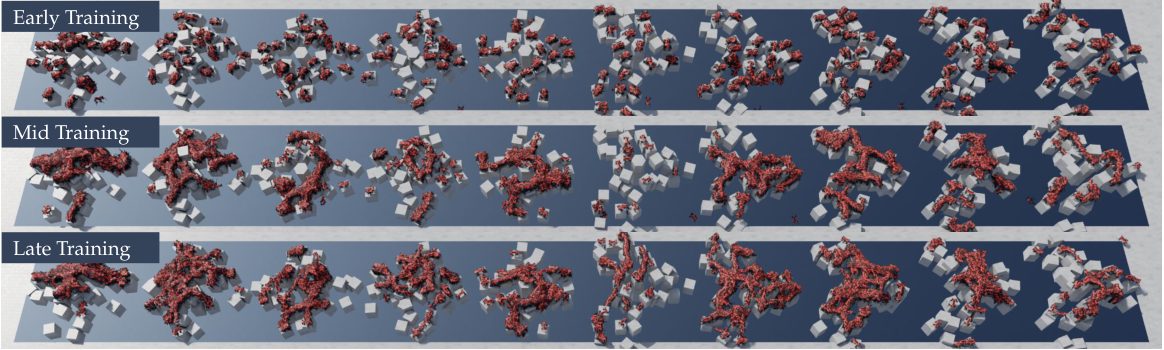
SGS 把 DemoStart 的二值过滤推广成连续加权:每个起点配置记录最近 100 次的成功率 p,用一个偏好中等成功率的 Beta 核给它打分,再按分数采样。在 100 万个环境上训练 Franka 拧螺母时,SGS 的成功率是 0.70,均匀采样是 0.06,PLR 是 0.05。去掉“靠近目标”类起点后成功率为 0;而有了这类起点,重力课程就没有必要了(69.4% 对 70.2%)。实验对象是夹爪和足式机器人。
核心观点
环境数越大,均匀采样浪费的比例越高。起点池建好之后,还需要按学习进度动态分配。
Lessons from Learning to Spin “Pens” [CoRL'24]
arXiv · Project · Code · Allegro 手
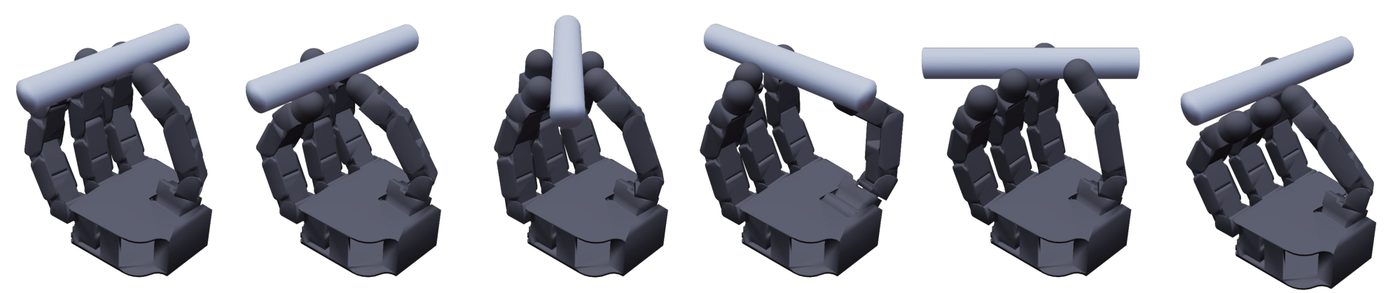
转笔需要手指不断交替接触。作者设计了 6 个“典型”起点抓取,正好位于食指、拇指、中指断开又重新接触的关键帧上(图 7)。只用其中一个起点时,策略学不会换指。
核心观点
对手内操作,“中间状态”应该按接触模式的切换点来选,而不是按任务阶段来选。
Human2Sim2Robot [arXiv'25]:人类先验进入起点分布
Crossing the Human-Robot Embodiment Gap with Sim-to-Real RL using One Human Demonstration · arXiv · Project · Code
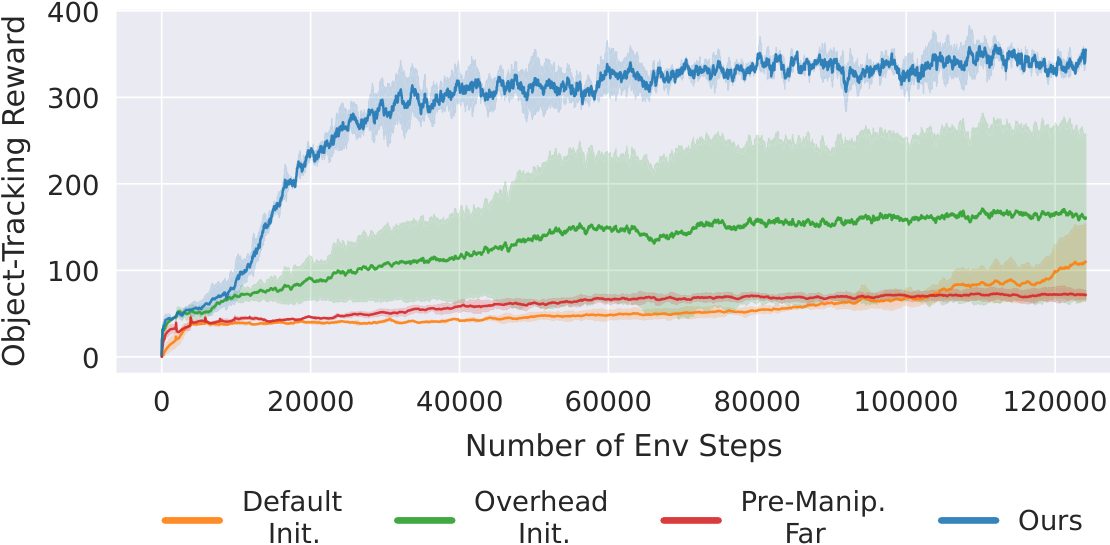
这篇工作从一段人类 RGB-D 视频中只提取两样东西:物体的位姿轨迹(用作奖励),以及手开始操作物体前的姿态(重定向后用作 RL 的初始状态)。消融显示,用人类的操作前手部姿态初始化,明显优于默认初始化、从上方初始化,以及把同一姿态放远一些再初始化(图 9)。另一个工作(Lin et al. 2025,人形机器人双手)报告了类似的结果:用人类数据初始化手部姿态后,双手交接任务里能学会的种子比例从 0% 提高到 30%。
核心观点
人类数据最直接的用途之一,是为多指手提供“手已经放对了位置”的初始状态。这恰好是仿真里最难自动生成的那一类中间状态。
3.2 改目标分布
第二类方法改的是任务本身:不再训练“完成某一个任务”的策略,而是训练一个以目标为条件的策略 $\pi(a\mid s,g)$,目标在很宽的分布上采样,并在一个回合内一个接一个地链起来。这样做在两个层面上缓解了 2.1 和 2.2。在一个回合内,每个新目标都离当前状态不远,总有一部分回合能达成,梯度一直存在。在任务层面,策略学到的是一个通用的“把物体送到任意位姿”的技能,下游任务只需要给出一串目标,不需要为每个任务设计奖励。
和改起点不同,改目标分布会改变优化的任务:预训练策略对“到达随机目标”是最优的,对具体的下游任务未必最优。所以要么下游任务本身就能表达成目标序列(零样本使用),要么需要在下游任务上微调。人类先验在这里可以只以物体轨迹的形式进入:从视频里提取物体位姿序列作为目标,完全不涉及手的形态差异。
SimToolReal [arXiv'26]
SimToolReal: An Object-Centric Policy for Zero-Shot Dexterous Tool Manipulation · arXiv · Project · Code · KUKA + 22 自由度 Sharpa 手
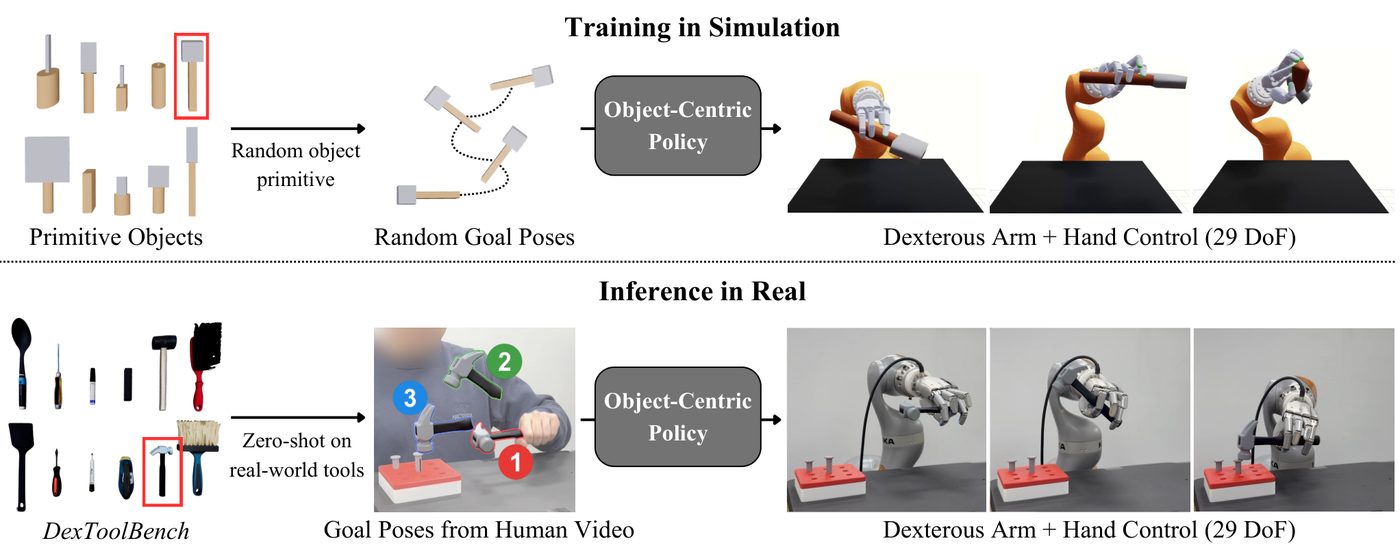
训练物体是程序化生成的“工具”:一个柄加一个头,每部分是长方体或胶囊体,尺寸和密度随机。第一个目标在工作空间内均匀采样,之后的每个目标与上一个相距不超过 10 cm、90°,成功的判据是 4 个关键点的最大误差小于 1 cm。部署时,从人类 RGB-D 视频中估计工具的位姿轨迹作为目标序列,零样本执行(图 10)。在 12 种真实工具、24 个任务上,任务进度比固定抓握和运动学重定向的基线高 37%,与针对单类工具训练的专门策略相当。训练用了约 1200 亿帧。作者的消融表明,把 SAPG 换成 PPO,或者去掉非对称 critic,性能都会大幅下降(图 11)。
核心观点
把一个稀疏任务换成一族互相接近的目标,就能让探索一直有信号;人类视频只需要贡献物体轨迹。代价是巨大的样本量,以及对比 PPO 更强的优化器的依赖。
Play2Perfect [arXiv'26]
Play2Perfect: What Matters in Dexterous Play Pretraining for Precise Assembly? · arXiv · Project · Code · 同一平台
Play2Perfect 把 SimToolReal 式的目标到达训练当作“玩耍”预训练,然后对每个装配任务只用稀疏奖励微调。奖励以稀疏任务信号为主,包括一个平滑项、每个子目标的一次性奖励,以及完成后撤手的奖励;子目标由 CAD 模型通过“拆卸再反转”自动生成。每个装配任务微调 2–5 小时即可学会,而从零训练的稀疏和稠密奖励基线 24 小时都没有一次成功(图 12)。真机上,间隙为 10 mm、2 mm、0.5 mm 的插入任务分别成功 10/10、9/10、6/10。
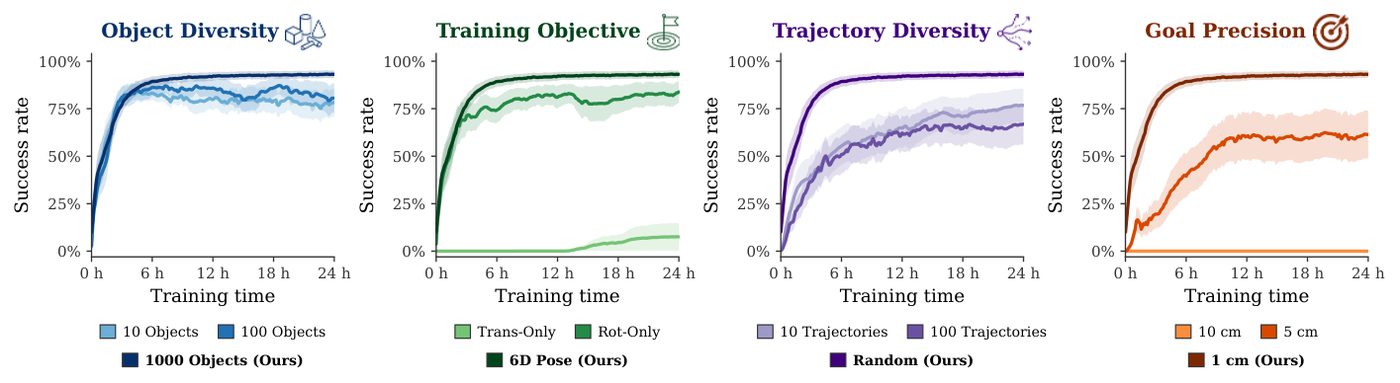
这篇的主要贡献是对预训练目标分布的消融(图 13):物体越多越好(1000 > 100 > 10);完整的 6D 目标比只有旋转好约 10 个百分点,只有平移的目标学不会手内重定向;在线随机生成的目标轨迹优于固定的轨迹库;目标容差为 1 cm 时最好,5 cm 停在约 60%,10 cm 学到的东西几乎无法迁移。
核心观点
目标分布决定了预训练学到哪一种技能。只要目标能用“固定抓握 + 移动手臂”完成,策略就只会学这个;目标必须足够精确、足够多样,才能逼出手指层面的操作。
DexterityGen(arXiv:2502.04307)从另一个角度印证了这一点:它用 RL 生成“从任意抓取到任意抓取”的转移数据,作者指出目标要选在当前状态附近,距离太远的目标会让 RL 很早停滞。
3.3 结构化探索
第三类方法针对 2.3 和 2.4,改的是策略的噪声分布,而不是任务或数据来源。具体有三种做法:把动作空间直接限制在一个低维子空间里;保留完整的动作空间,只改变噪声的协方差;或者用多个策略组成的种群来提供探索的多样性。前两种做法里,人类先验以“手部协同”(人手姿态的主成分)的形式进入。
DextrAH-G [CoRL'24]
DextrAH-G: Pixels-to-Action Dexterous Arm-Hand Grasping with Geometric Fabrics · arXiv · Project · Code · Kuka + Allegro
策略的动作是 6D 手掌位姿加上 5 维 PCA 手部动作,PCA 来自重定向后的 DexYCB 人手数据,总共 11 维,而不是 23 个电机。下层用几何 fabrics 控制器处理避障和关节限位。和关节空间相比,PCA 动作空间收敛更快,抓法也更接近人类(图 2、图 14);关节空间在单物体上慢约 4 倍,在多物体训练中完全失败。作者自己指出的局限是,PCA 会限制手内操作的灵巧性。
核心观点
把动作空间降到人手协同子空间,能直接解决 2.3,代价是能力的上限被这个子空间封住。
EigenDEXplore [arXiv'26]
EigenDEXplore: Structured Exploration for Dexterous Manipulation with Human Priors · arXiv · Project · Code
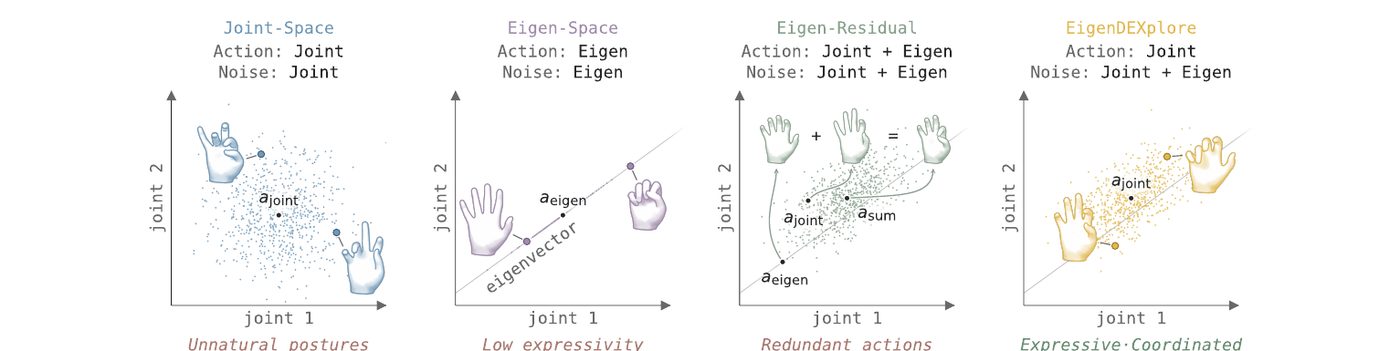
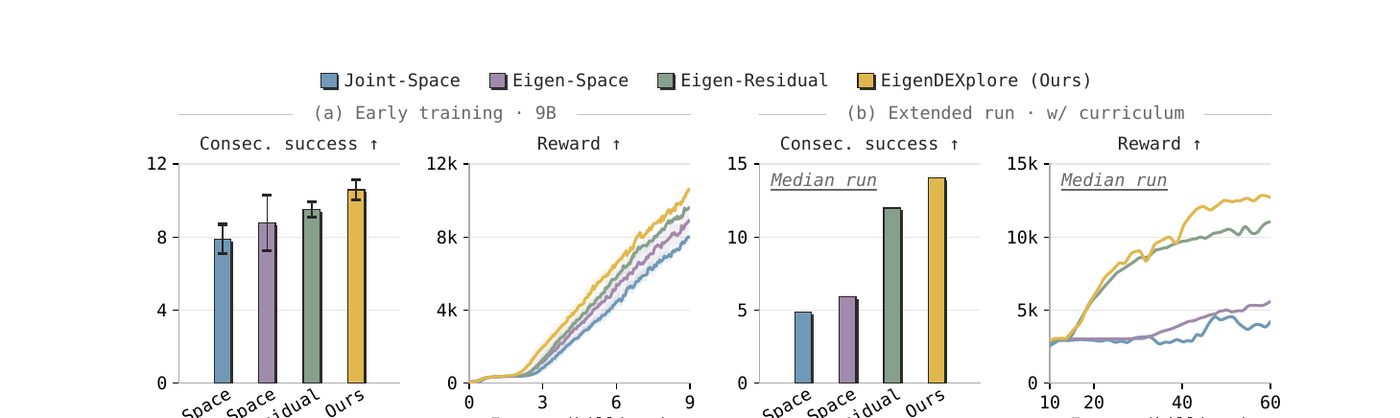
EigenDEXplore 把“动作空间”和“噪声空间”分开处理。它把大规模人手姿态数据重定向到目标机器人手,在关节空间做 PCA,保留 90% 方差(22 自由度的 Sharpa 手是 9 维)。动作空间仍然是完整的关节空间;探索噪声除了每个关节独立的一份,还有沿主成分方向的一份:
两组噪声尺度都由 PPO 学习,部署时只用均值,这组基就不再需要了。图 15 对比了四种组合:关节空间,降维到 eigen 空间,eigen 残差,以及 EigenDEXplore。在 SimToolReal 上训练 600 亿帧时,连续成功次数分别约为 4.9、6、12.0 和 14.1(图 16);直接降维到 eigen 空间,训练早期领先,需要精度时掉队。真机工具使用的任务进度是 82% 对 33%(关节空间)。两个对照实验说明了收益的来源:用谱相同但方向随机的正交基,效果比关节空间还差;在已经有课程和辅助奖励的 DexMachina 上,收益只在去掉这些帮助之后才出现。
核心观点
人类先验只改“怎么抖”、不改“能做什么”时,既能加速探索,又不封住上限。起作用的是人类的方向本身,不是“低维”这件事;而且当其他形式的帮助已经足够时,这份收益会消失。
SAR [RSS'23] 与 Lattice [NeurIPS'23]
SAR · arXiv · Project · Code
Lattice · arXiv · Code · 肌肉骨骼手
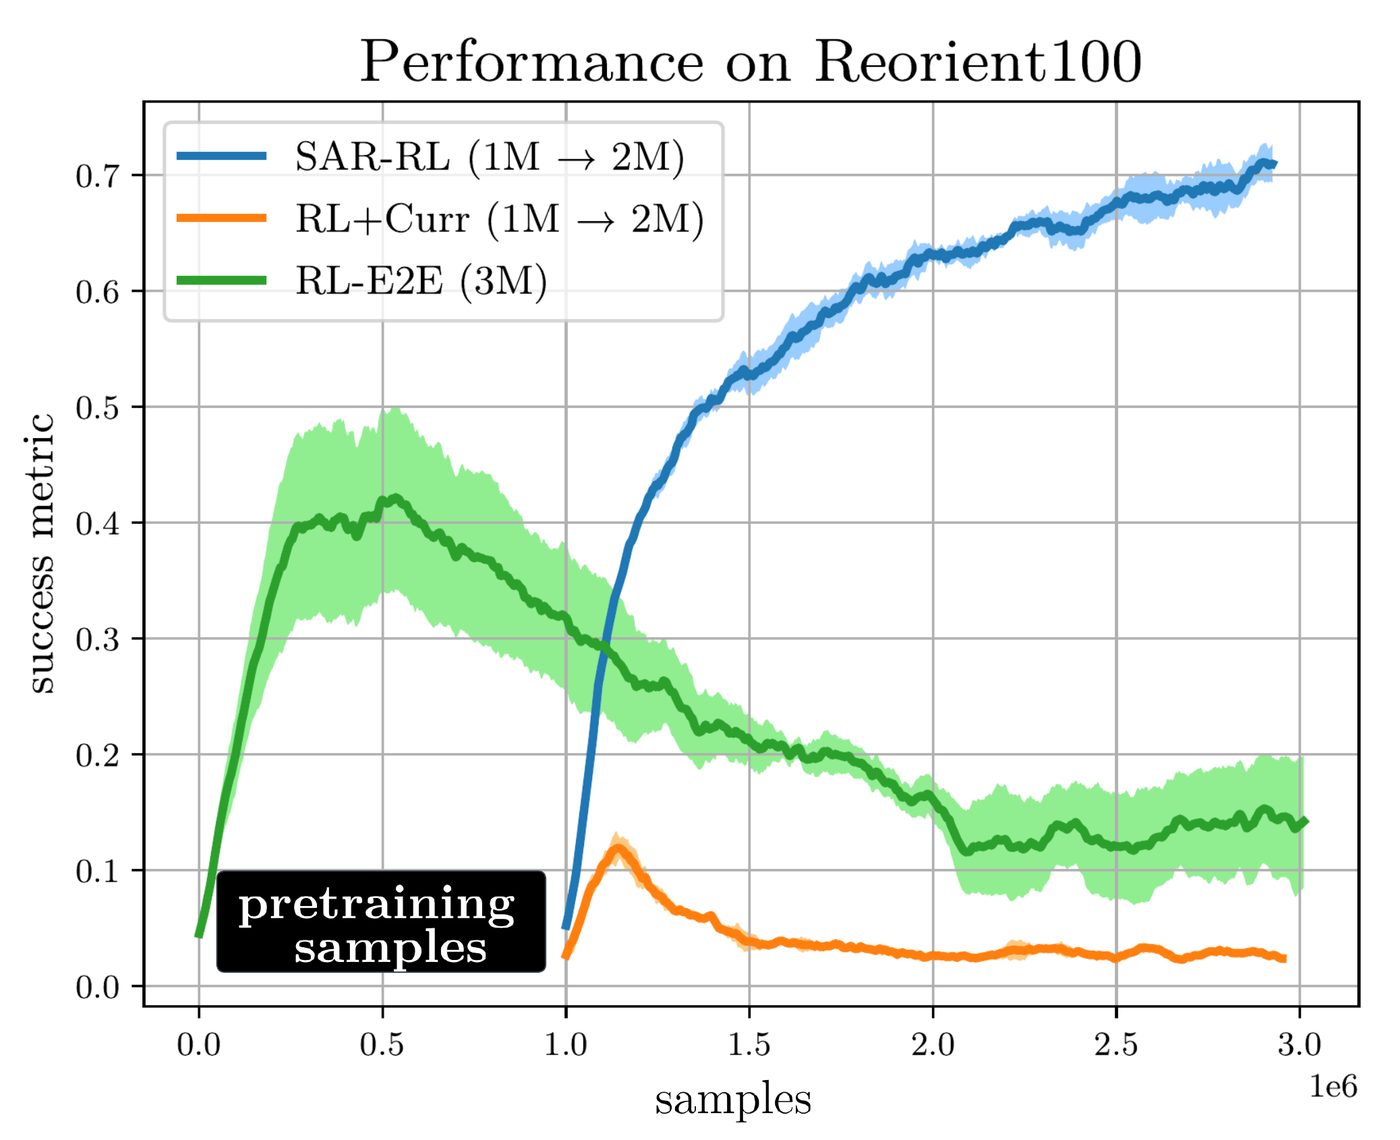
这两篇来自肌肉骨骼控制领域,那里的冗余比机器人手更严重(MyoHand 有 39 块肌肉)。SAR 先在一个简单任务上训练策略,从它的肌肉激活中提取协同,再把协同作为新任务的动作表示:在 100 个物体的重定向任务上,SAR 的成功率超过 70%,端到端训练和课程训练的基线都低于 20%(图 17)。Lattice 把时间相关的噪声注入策略网络的隐层,使不同执行器之间的噪声相关;论文的论点是,各执行器独立的噪声在过驱动系统中效率很低。
核心观点
协同不一定来自人类,也可以从策略在简单任务上的行为中提取;关键是让探索噪声在执行器之间相关。
DexPBT [RSS'23] 与 SAPG [ICML'24]
DexPBT · arXiv · Project · Code
SAPG · arXiv · Project · Code
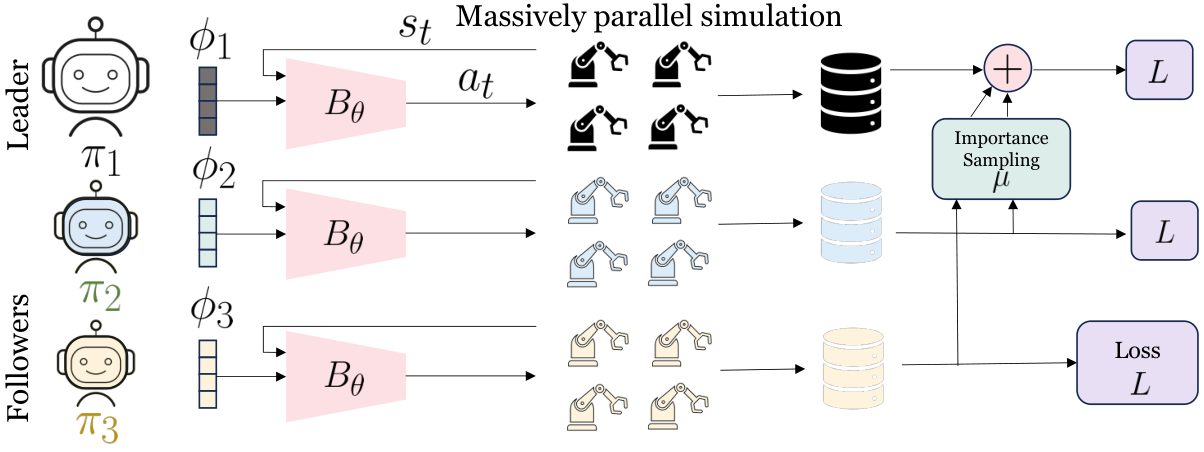
这两篇针对的是 2.4,把“多个策略”当作探索的来源。DexPBT 同时训练 8–32 个 PPO 策略,定期把表现好的复制给表现差的,并扰动超参和奖励系数;在双臂重定向任务上,它接近 40 次连续成功,而最好的独立种子不到 10 次。SAPG 把环境分给若干个共享主干、带各自可学习嵌入的跟随策略,主策略通过重要性采样吸收它们的数据(图 18);在双臂重定向任务上,SAPG 为 28.6,DexPBT 为 14.5,PPO 为 1.7。也有不同意见:Beukman et al.(RLC 2026)指出,只要把 PPO 的 minibatch 大小调回合理范围,PPO 就能接近 SAPG,饱和的一部分原因是超参没有随环境数正确缩放。
核心观点
在高维任务上,单个高斯策略产生的数据多样性有限,策略层面的多样性是另一种探索。不过在下这个结论之前,应先排除 PPO 超参缩放不当的可能。
3.4 动作跟踪
第四类方法把人类先验用得最充分:给定一段人类的手-物交互,把手部动作重定向到机器人手上,然后训练策略去跟踪这条参考轨迹。奖励由参考给出,通常包括物体位姿误差、手腕和关节误差、接触项。和前几类相比,跟踪为每一个时刻都提供了目标,同时解决 2.1、2.2 和一部分 2.3;而且任务可以从数据批量生成,不需要逐个设计奖励。
它的困难也很集中。第一,人手和机器人手的形态差异使运动学重定向的结果在物理上往往不可行,直接回放几乎全部失败。第二,精确跟踪本身就是一个难探索问题,手必须先建立正确的接触。第三,跟踪一条参考轨迹的策略,离开这条参考后泛化很差。第四,到底该跟踪物体还是跟踪手,并不显然。下面几篇工作分别回答了其中一个或几个问题。
ManipTrans [CVPR'25]
ManipTrans: Efficient Dexterous Bimanual Manipulation Transfer via Residual Learning · arXiv · Project · Code
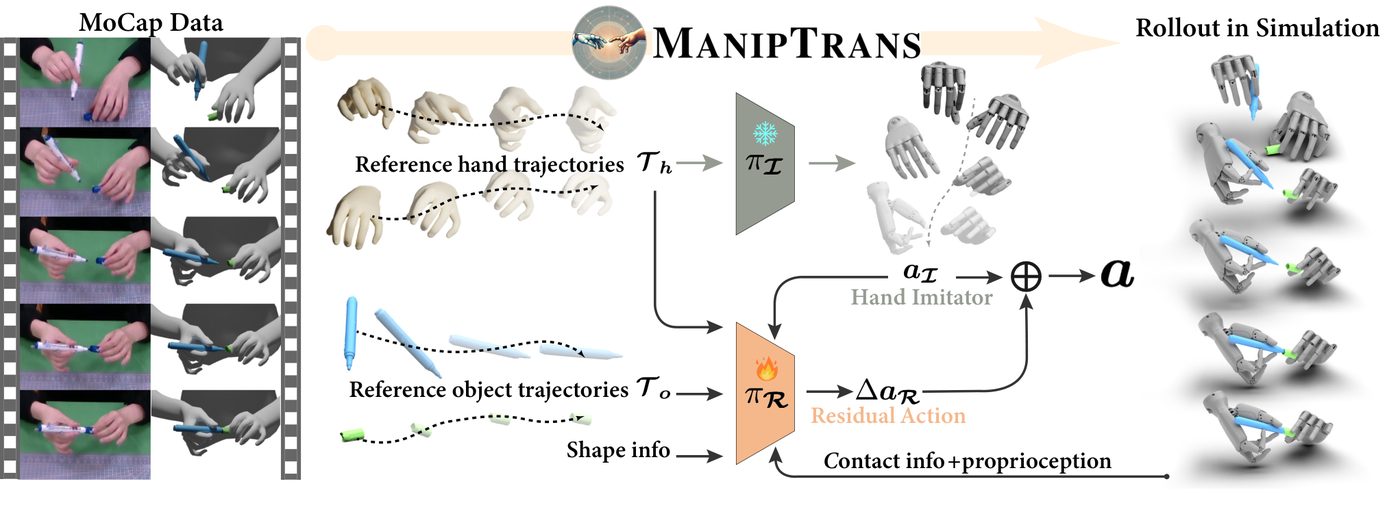
ManipTrans 把迁移分成两步:先用大规模人手数据预训练一个只模仿手部动作的模型,再针对具体任务训练一个残差策略,处理物体交互带来的物理约束(图 19)。它的对比实验量化了形态差距的影响。成功率(单手 / 双手):只做运动学重定向为 4.6% / 0.0%;只用 RL 为 34.3% / 12.1%;重定向加残差为 47.8% / 13.9%;完整方法为 58.1% / 39.5%。
核心观点
先解决“手怎么动”,再单独学“怎么和物体交互”。这种两阶段分解,把形态差距和接触物理拆成了两个可以分别处理的问题。
DexTrack [ICLR'25]
DexTrack: Towards Generalizable Neural Tracking Control for Dexterous Manipulation from Human References · arXiv · Project · Code
DexTrack 训练一个通用的跟踪控制器,方法是 RL 加上对高质量跟踪示范的模仿。难点在于,难的参考轨迹本身就拿不到成功的示范。作者用同伦优化来挖掘示范:先解与之相关的简单轨迹,再沿一条路径逐步过渡到困难的轨迹;挖出的示范又用来改进控制器,两者交替迭代(图 20)。成功率比最强的基线高 10% 以上。
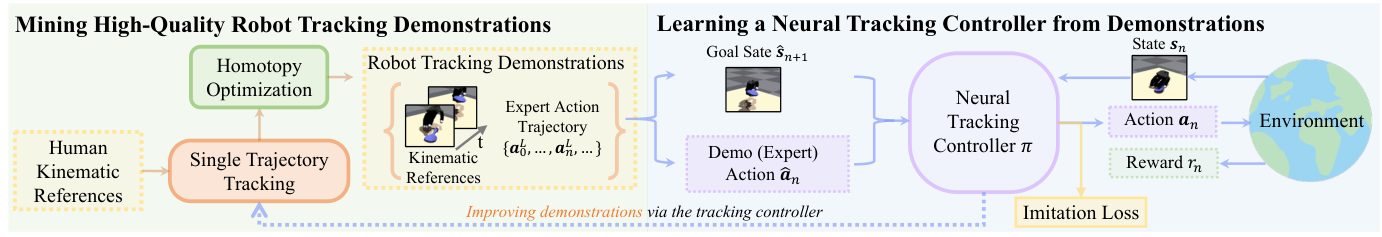
核心观点
通用跟踪器的瓶颈在于难轨迹的示范数据,而难轨迹的示范可以从易轨迹逐步“推”过去得到。
DexMachina [ICML'26]
DexMachina: Functional Retargeting for Bimanual Dexterous Manipulation · arXiv · Project · Code · Genesis · 6 种机器人手
DexMachina 研究“功能重定向”:给定一段人类双手操作铰接物体的示范,让机器人手把物体沿同样的轨迹操作,不要求手部动作和人一样。核心机制是虚拟物体控制器:在物体上加一组弹簧阻尼器,把物体沿示范轨迹拉着走,相当于仿真器替策略完成了一部分操作;每当奖励达到阈值,控制器的增益按指数衰减,控制权逐步交还给策略(图 21)。作者的结论是课程最关键:只用任务奖励不够;辅助奖励(模仿、行为克隆、接触)的增益不稳定;ManipTrans 式的物理参数和阈值课程没有明显收益(图 22)。该工作没有真机实验。
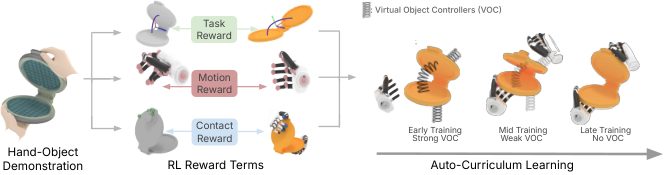
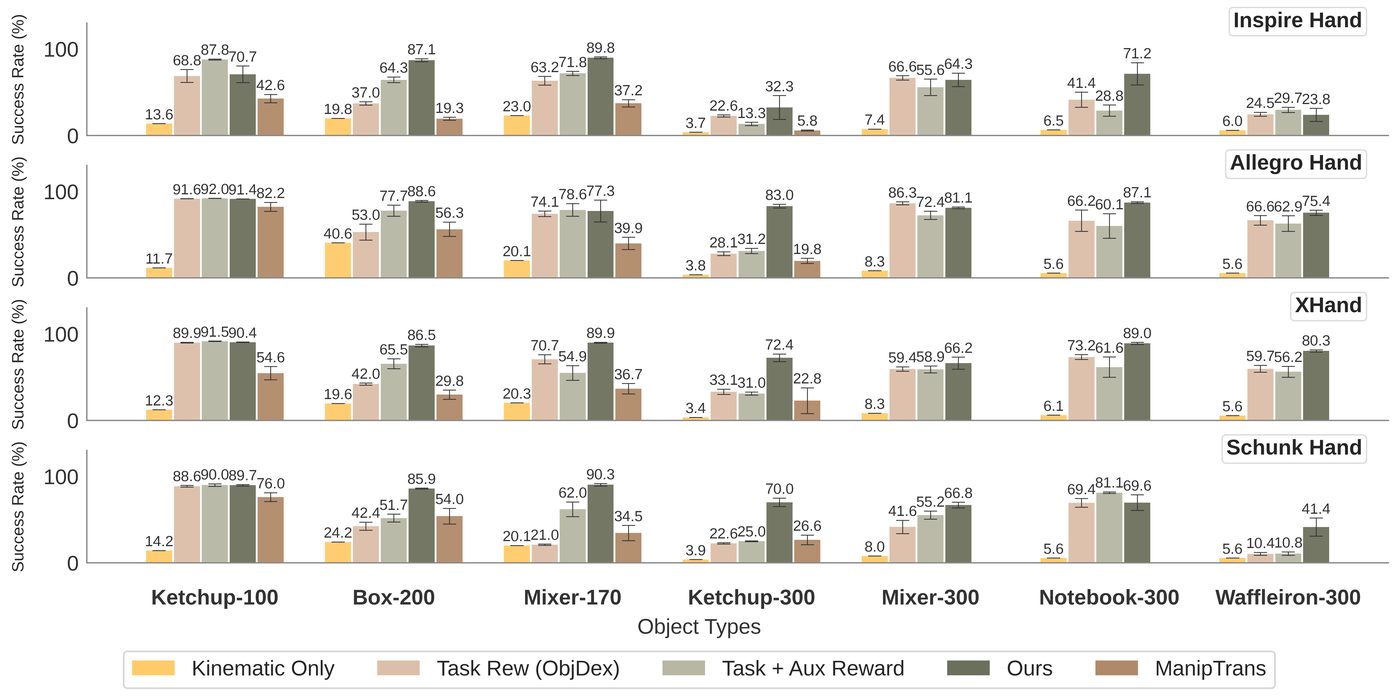
核心观点
跟踪的探索难题可以通过“先让物理帮忙、再撤掉帮忙”来解决,在这组实验中,这比堆叠辅助奖励更有效。
DONIC [arXiv'26]
DONIC: Generalist Dexterous Bimanual Tracking Control from Human Demonstrations · arXiv · Project · Code · 两只 Wuji Hand V1
DONIC 训练一个通用的双手跟踪控制器,数据约 3400 段,包括作者新采集的 BiHOI 数据集(1575 段,229 个物体)和多个公开数据集。方法上有三点(图 23):残差动作叠加在下一帧参考上;以物体为中心、每只手单独计算的奖励,其中接触项按参考中“哪根指尖应该接触”来开关;以及按片段扣除平均优势值,消除不同片段难度差异带来的偏差。此外,它把回放验证成功的轨迹放进示范库,做 PPO + 行为克隆。一个模型在未见轨迹上的成功率为 86.8%,在未见物体上为 57.3%,最强的基线分别只有 9–12%。两个新设计各自贡献 5–9 个百分点。没有真机实验。
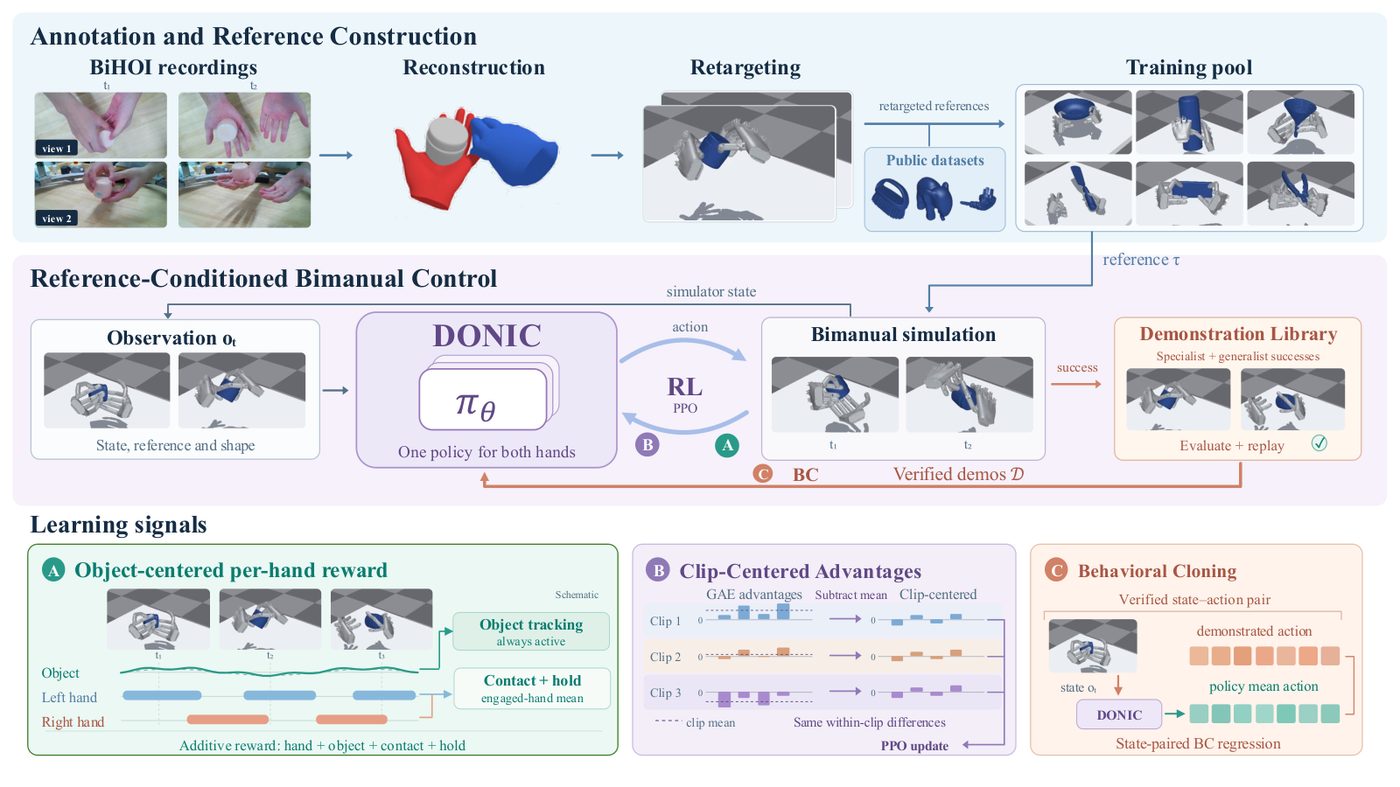
核心观点
方法本身是若干已有部件的组合,单项贡献都不大,从消融来看,大幅领先更依赖数据规模和完整的训练配方。值得注意的是,它所用的手形态接近人手,跟踪整只手的动作依然有效。
AdaDex [arXiv'26]
AdaDex: Learning Adaptable Dexterous Skills via Hybrid Dexterous Mimicking · arXiv · Project · XHand、Wuji、Sharpa 等
AdaDex 直接面对“跟踪泛化差”的问题。同一个策略同时在两种并行环境中训练(图 24)。跟踪环境用稠密的跟踪奖励,起点从参考轨迹上采样,并按各段成功率的方差自适应分配。泛化环境的起点和目标都加了大幅噪声,奖励是稀疏的物体成功,只保留对手腕的稠密引导。每个技能只需要几秒钟的人类片段。在 GRAB 上,见过的动作进度为 96.7%,未见过的为 80.0%,而 ManipTrans 为 35.2% 和 7.3%。消融非常干净:去掉跟踪环境,所有指标都降到约 8%;去掉泛化环境,见过的动作不受影响(97.5%),未见过的降到 31.8%。
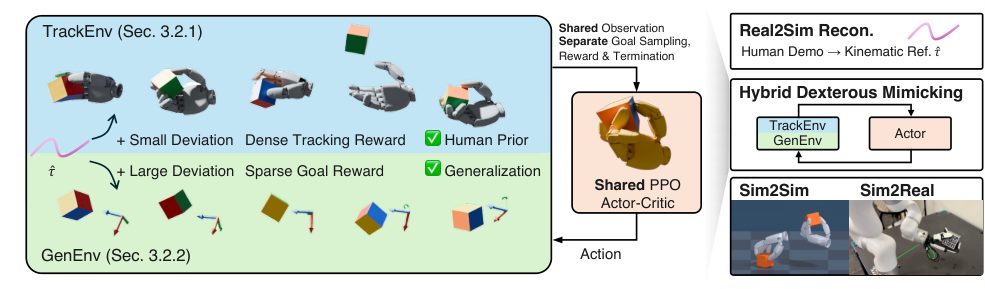
核心观点
跟踪提供“往哪走”,加噪的起点和目标提供“覆盖面”,两者在同一个批次里互补,缺一不可。这组消融直接展示了人类先验与状态覆盖各自的作用。
TeleDexter [arXiv'26]
Towards Human-level Dexterous Teleoperation · arXiv · Project · Franka + LeapHand / Sharpa · 4 张 RTX 5090,约 6.2 万个环境,约 10¹⁰ 步
TeleDexter 训练的是遥操作的底层控制器:操作者通过动捕给出指尖和物体的目标,策略输出关节指令。它的参考同样来自人类动捕,但不是作为一条要贴着走的轨迹,而是切成一串连续的子目标;回合从参考上的随机帧开始,并允许跨轨迹切换(图 25)。奖励以子目标到达的稀疏奖励为主,加上 0.1 倍的稠密跟踪项。这种混合奖励能连续完成 32.6–186.6 个子目标,纯稠密跟踪只有约 2.7 个。在 7 个任务上,遥操作成功率为 75.2%,其他方法为 0–9%。另一个对迁移很重要的设计是随机动作屏蔽:随机让部分动作维度在一段时间内保持上一步的指令。去掉它,真机螺丝刀任务的成功率从 73% 降到 0%。
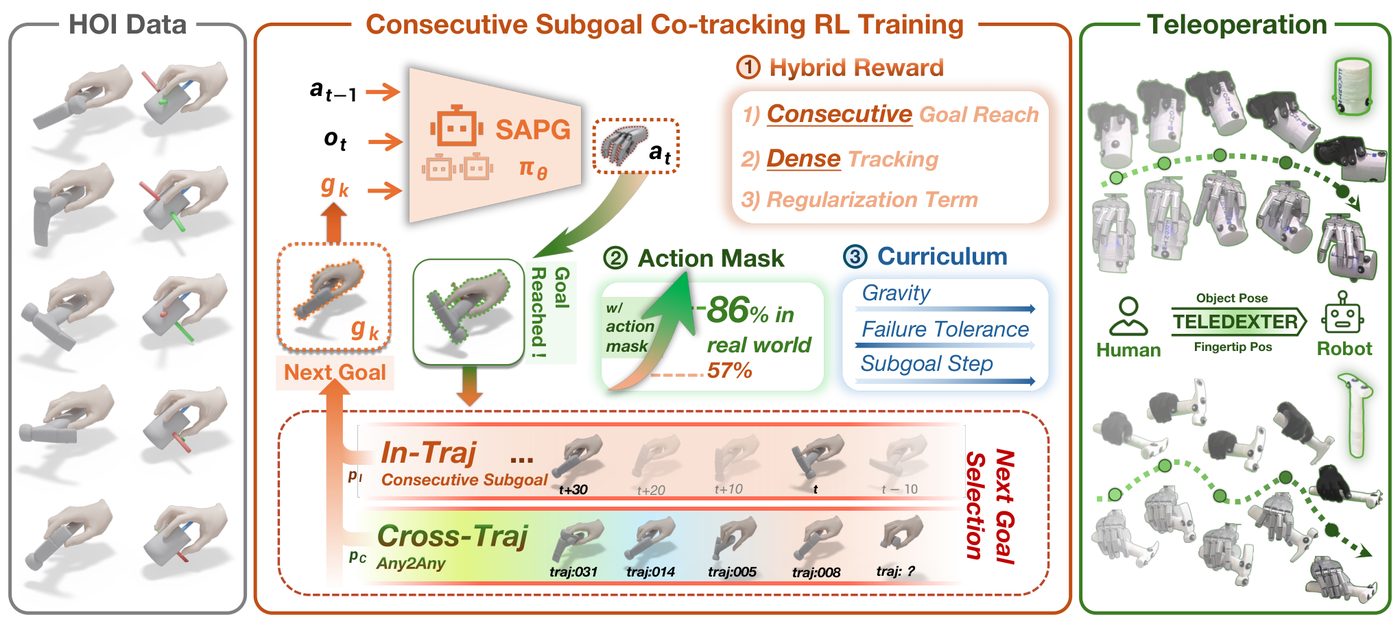
核心观点
同样的人类参考,当作一串要依次到达的目标来用,远比当作一条要逐帧贴合的轨迹来用有效。这实际上是把第 3.2 节的“目标”思路用在了跟踪上。
跟踪物体还是跟踪手
几篇工作直接对比了这个问题。Human2Sim2Robot 发现,在物体轨迹奖励之外再加手部跟踪奖励,或者在回放的示范上学残差,都没有带来实质提升(图 26),作者的结论是高精度的人手数据并非必要。ObjDex(arXiv:2411.04005)用人类数据生成手腕轨迹,手指交给 RL,并指出由于形态差异,人类手指动作“并不总是有用”。另一方面,DONIC 和 AdaDex 跟踪整只手的效果都很好,而它们用的手(Wuji、Sharpa、XHand)在比例和拇指结构上更接近人手。我的理解是:手越像人,跟踪手部动作的代价可能越小;手和人差得越多,物体轨迹加上手腕或预抓取姿态,可能是更合适的起点。这是跨论文的推测,并不是对不同手形态做过控制变量比较后的结论。
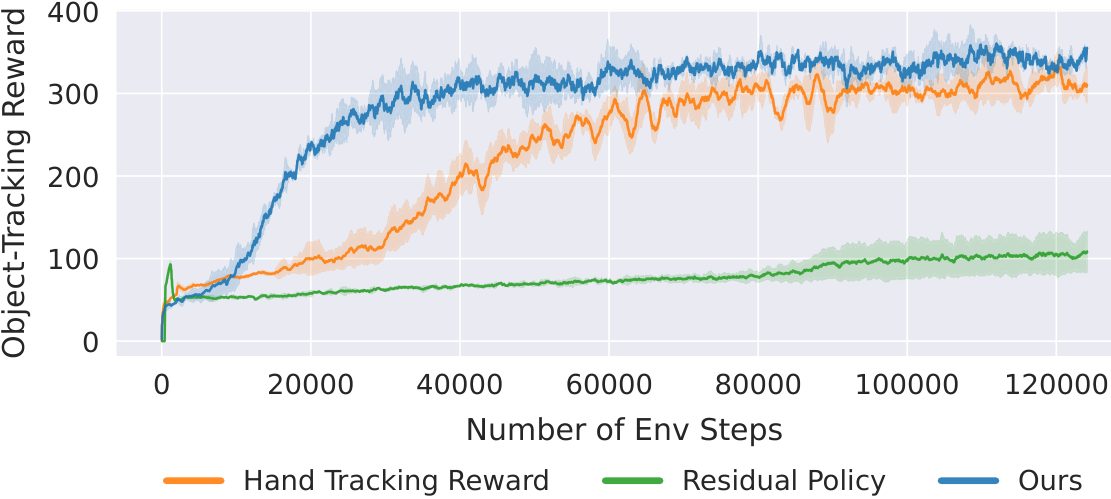
Do as I Do [arXiv'26]:参考从哪里来
Do as I Do: Dexterous Manipulation Data from Everyday Human Videos · arXiv · Project · Code · 双臂 UR3e + Sharpa · 不是 RL
跟踪类方法都依赖高质量的参考。Do as I Do 尝试从单目的网络视频中获取参考:先用视觉基础模型重建手和物体的运动,再在仿真里用基于采样的轨迹优化(SPIDER 式的 MPPI)把运动学重定向的结果修成物理可行的轨迹,最后在真机上回放(图 27)。这篇工作不训练策略。针对视频重建的噪声,作者加了预热步、随机扰动和过渡奖励,把重定向成功率从 0.25 提高到 0.71。数据产出率很低:2000 段预筛过的网络视频中,只有 9% 有有效的交互,约 4% 通过质量检查。
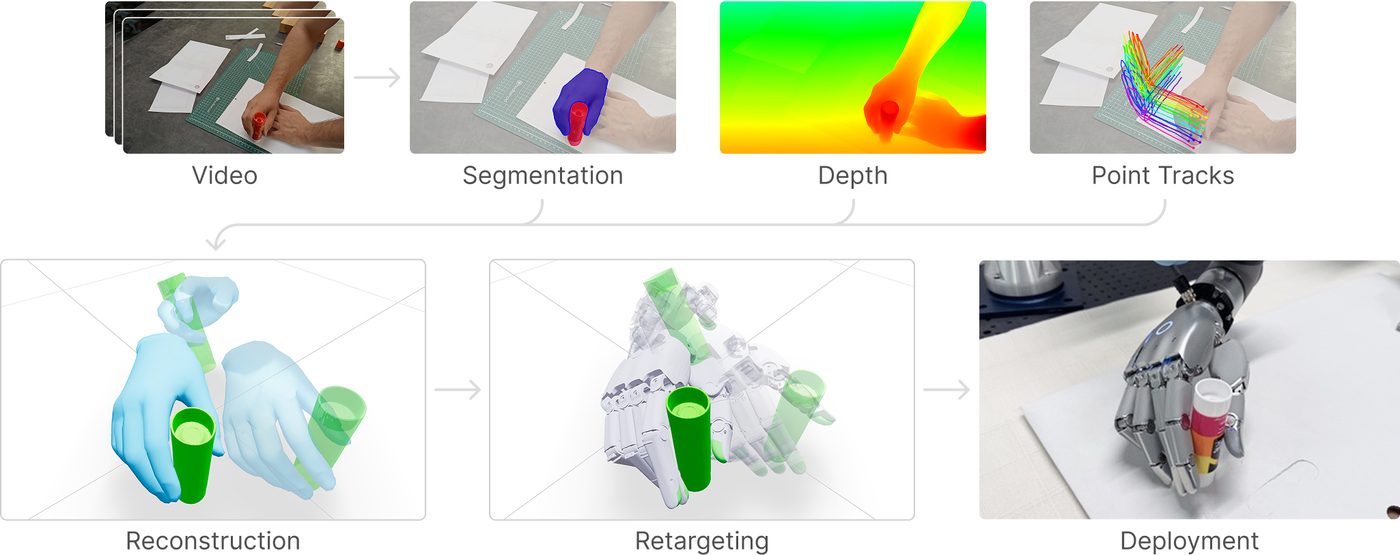
核心观点
人类视频在原则上很便宜,但要变成物理可行的参考,重建和可行性筛选会损失约 20 倍的数据量。对跟踪类方法,参考数据的获取本身就是主要成本。
3.5 接触先验与修改物理
除了上面四类,还有两类改动在文献中反复出现,并且各自有前四类替代不了的作用。
3.5.1 接触先验
同一个任务往往有很多种抓法和手指配置,稠密奖励只约束物体,不约束手指放在哪里,于是策略常常找到奇怪的接触方式(2.2)。接触先验在奖励里指定希望的接触位置,但不规定完整的手部轨迹。它提供的信息比目标多,比完整跟踪少,而且只涉及接触点,对手的形态差异不敏感。
Twisting Lids Off with Two Hands [CoRL'24]
arXiv · Project · Code · 两只 Allegro 手
双手拧瓶盖。作者在瓶身和瓶盖上设置参考接触点,奖励手指靠近这些点。不带接触提示的步态奖励会产生杂乱的手指动作;把接触奖励的系数调小,策略就学不会拧(图 28)。这篇工作在物理建模上也有值得注意的地方:瓶盖用带“刹车”摩擦的转动关节建模,作者用它来复现任务所需的静摩擦行为。
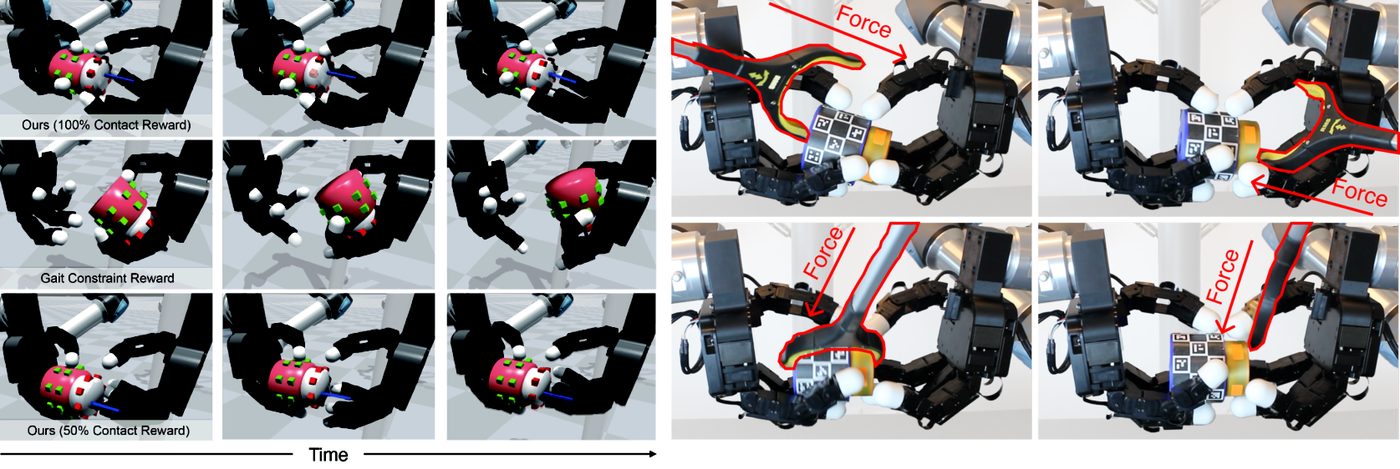
人形机器人的视觉灵巧操作 [CoRL'25]
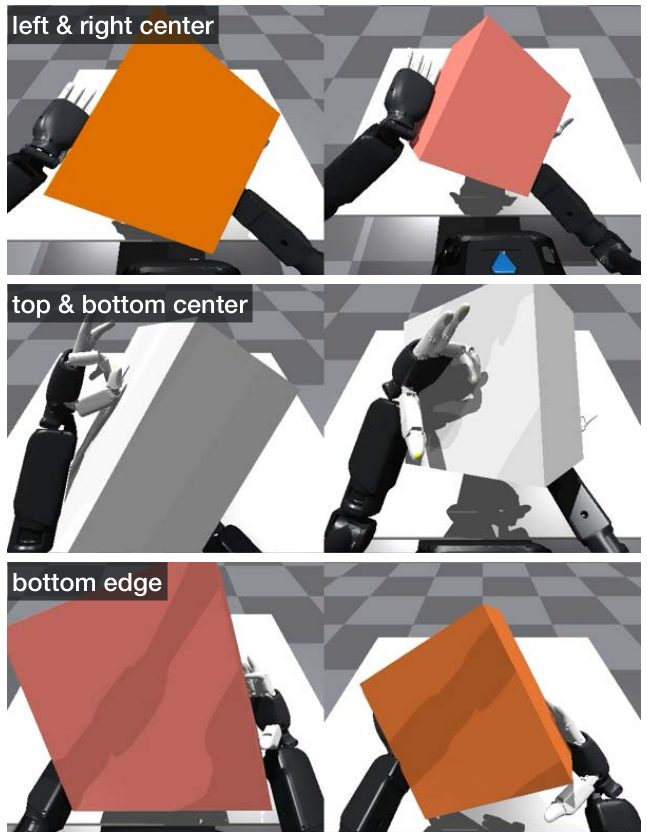
Sim-to-Real Reinforcement Learning for Vision-Based Dexterous Manipulation on Humanoids · arXiv · Project
在物体上放置“接触贴纸”作为接触目标,和物体目标一起组成奖励。贴纸的位置决定了涌现的接触模式(图 29),同一套奖励形式可以复用到抓取、抬箱子、双手交接等任务上。
核心观点
接触点是一种低维的、与手的形态基本无关的先验。它恰好约束了稠密奖励最容易出错的部分,也就是手指放在哪里。
3.5.2 修改物理
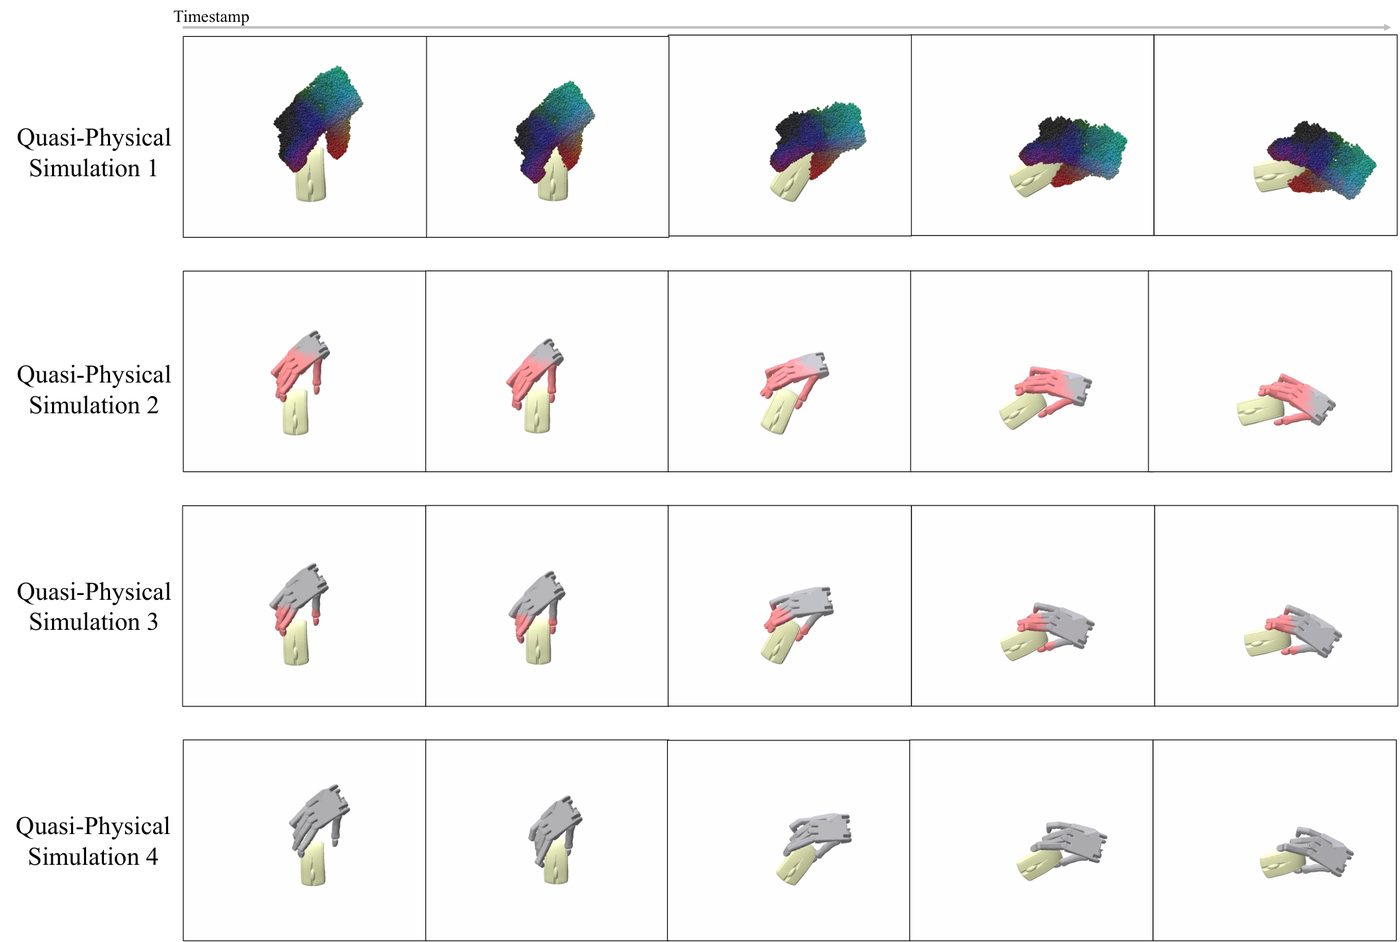
最后一类改的是转移 P。它有两种动机。一种是为了可学性:先把物理放松,让策略容易成功,再逐步恢复真实物理。DexMachina 的虚拟物体控制器属于这一种;QuasiSim(arXiv:2404.07988)把人手动作迁移到机器人手时,用一组从“放松接触、可微”到“真实”的准物理仿真器构成课程(图 30);不少工作在训练早期降低重力。另一种是为了可行性:螺纹、静摩擦这类接触现象很难仿准,或者仿准的代价太高,于是有意用更简单的模型替代。
DexScrew [arXiv'25]
Learning Dexterous Manipulation Skills from Imperfect Simulations · arXiv · Project · Code · UR5e + 12 自由度 XHand + 指尖触觉
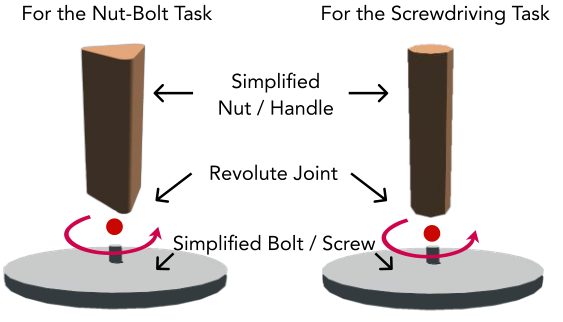
DexScrew 做拧螺母和用螺丝刀。仿真里不建螺纹:螺母或螺丝刀柄只是通过转动关节连在底座上的刚体(图 31)。流程分三步(图 32):在简化仿真里用特权 PPO 学会手指转动技能,并蒸馏成只用本体感觉历史的策略;在真机上,操作者用 VR 手柄控制手腕,同时调用这个学好的手指技能,以此采集数据;最后用这些真机数据加上触觉训练行为克隆策略。螺丝刀任务的进度:仿真策略直接迁移为 41.6%,且没有一次拧到底;行为克隆不用触觉和历史为 69.2%;两者都用为 95.0%。
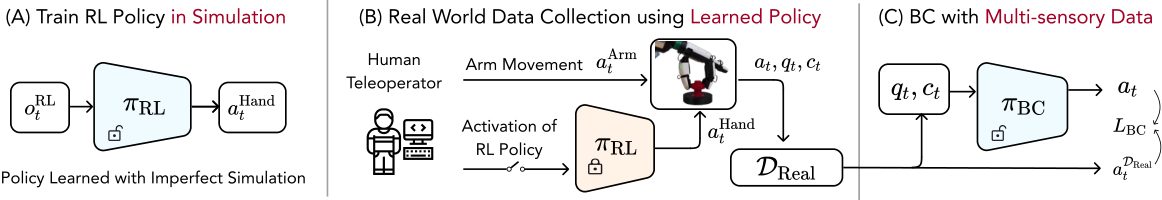
核心观点
仿真只需要教会技能本身,不必把接触物理仿准;缺失的部分,可以用借助这个技能采集的少量真机数据补上。
4 横向比较
把六类方法放在一起,可以按它们改动了 RL 问题的哪个部分,以及是否改变了原任务的最优解来比较。
| 方法类别 | 改动的部分 | 是否改变原任务的最优解 | 主要针对 | 人类先验的形式 | 代表工作 |
|---|---|---|---|---|---|
| 起点分布 | $\rho_0$ | 在第 3.1 节假设下,不改变逐状态最优策略 | 2.1、2.2 | 预抓取姿态 | OmniReset、DemoStart、SGS、Penspin、Human2Sim2Robot |
| 目标分布 | g 的分布 | 是,换成目标到达的任务族,需要零样本表达或微调 | 2.1、2.2 | 物体轨迹 | SimToolReal、Play2Perfect |
| 结构化探索 | 策略噪声或动作表示 | 只改噪声时不必;限制动作空间时可能改变 | 2.3、2.4 | 手部协同 | EigenDEXplore、DextrAH-G、SAR、DexPBT、SAPG |
| 动作跟踪 | 奖励 r(以及起点) | 是,偏向参考 | 2.1–2.3 | 完整的手-物轨迹 | ManipTrans、DexTrack、DexMachina、DONIC、AdaDex、TeleDexter |
| 接触先验 | 奖励 r | 是,偏向指定接触 | 2.2 | 接触位置 | Twisting Lids、人形机器人灵巧操作 |
| 修改物理 | 转移 P | 是,需要退火或真实数据补偿 | 2.1,以及仿真代价 | 沿示范施加的辅助力 | DexMachina、QuasiSim、DexScrew |
改采样,还是改任务。 起点选择和探索噪声可以改变样本从哪里来,而不改部署时要解决的任务。种群训练提供了策略层面的多样性,不过如果同时扰动奖励系数,各个成员的优化目标也会改变。这些做法可以组合,前提是能生成有用的中间状态或噪声方向。跟踪、接触奖励和修改物理提供了更强的引导,也改变了目标或动力学。值得问的是:去掉这些帮助后,策略靠什么完成任务?DexMachina 让辅助力衰减到零,Play2Perfect 在下游任务上微调,DexScrew 用真机数据补偿。ManipTrans 和 DONIC 的残差可以修正参考动作,但残差本身不会消除跟踪奖励对参考的偏好。
人类先验进入的位置,决定了形态差异的影响。 预抓取姿态进入起点,物体轨迹进入目标,手部协同进入噪声,完整轨迹进入奖励。起点和噪声可以引导学习,而不要求最终动作模仿人类;物体目标仍然改变任务分布,但没有规定人类的手指动作。完整的手部跟踪则更直接地约束解。文献中的观察与这个区分一致:EigenDEXplore 只改噪声时最好,降维到 eigen 空间则后期掉队;Human2Sim2Robot 和 ObjDex 发现手指跟踪作用有限;DONIC 和 AdaDex 在形态接近人手的手上跟踪整只手依然有效。
各类方法之间会互相替代。 一个方法的收益,取决于其他部分已经提供了多少帮助。OmniReset 的起点足够多样时,奖励权重几乎不重要;SGS 有了“靠近目标”的起点后,重力课程变得多余;EigenDEXplore 在 DexMachina 上只在去掉课程和辅助奖励后才有收益;Play2Perfect 有了预训练之后,只用稀疏任务奖励就够了。因此,单篇论文的消融结论都是在它自己的其他设定下成立的,跨论文比较“什么最重要”时要把这些条件一起看。
我还想看到的部分。 就操作任务而言,OmniReset 和 SGS 的大规模起点生成主要在夹爪上验证;多指手、尤其是双手同时稳定接触的中间状态,仍然很难大规模生成。人类的预抓取姿态和双手交互动捕可能正好用在这里。跟踪类方法有了人类先验,但起点覆盖面远不及 OmniReset 那样的规模;起点类方法有覆盖面,对人类先验的利用还比较有限。用人类数据产生多接触的起点和目标,再按学习进度分配起点采样,放到大规模并行仿真里训练,我觉得值得更系统地试一试。
参考文献
Rajeswaran et al. Learning Complex Dexterous Manipulation with Deep Reinforcement Learning and Demonstrations (DAPG). RSS 2018. arXiv:1709.10087 · Project · Code.
Petrenko et al. DexPBT: Scaling up Dexterous Manipulation for Hand-Arm Systems with Population Based Training. RSS 2023. arXiv:2305.12127 · Project · Code.
Berg et al. SAR: Generalization of Physiological Agility and Dexterity via Synergistic Action Representation. RSS 2023. arXiv:2307.03716 · Project · Code.
Chiappa et al. Latent Exploration for Reinforcement Learning (Lattice). NeurIPS 2023. arXiv:2305.20065 · Code.
Singla, Agarwal, Pathak. SAPG: Split and Aggregate Policy Gradients. ICML 2024. arXiv:2407.20230 · Project · Code.
Lum et al. DextrAH-G: Pixels-to-Action Dexterous Arm-Hand Grasping with Geometric Fabrics. CoRL 2024. arXiv:2407.02274 · Project · Code.
Lin et al. Twisting Lids Off with Two Hands. CoRL 2024. arXiv:2403.02338 · Project · Code.
Wang et al. Lessons from Learning to Spin “Pens”. CoRL 2024. arXiv:2407.18902 · Project · Code.
Liu et al. QuasiSim: Parameterized Quasi-Physical Simulators for Dexterous Manipulations Transfer. ECCV 2024. arXiv:2404.07988 · Project · Code.
ObjDex: Object-Centric Dexterous Manipulation from Human Motion Data. 2024. arXiv:2411.04005 · Project · Code.
HOP: Hand-Object Interaction Pretraining from Videos. 2024. arXiv:2409.08273 · Project · Code.
Bauza et al. DemoStart: Demonstration-led Auto-curriculum Applied to Sim-to-Real with Multi-fingered Robots. ICRA 2025. arXiv:2409.06613 · Project.
Liu et al. DexTrack: Towards Generalizable Neural Tracking Control for Dexterous Manipulation from Human References. ICLR 2025. arXiv:2502.09614 · Project · Code.
Li et al. ManipTrans: Efficient Dexterous Bimanual Manipulation Transfer via Residual Learning. CVPR 2025. arXiv:2503.21860 · Project · Code.
Yin et al. DexterityGen: Foundation Controller for Unprecedented Dexterity. 2025. arXiv:2502.04307 · Project.
Lum et al. Crossing the Human-Robot Embodiment Gap with Sim-to-Real RL using One Human Demonstration (Human2Sim2Robot). 2025. arXiv:2504.12609 · Project · Code.
Lin et al. Sim-to-Real Reinforcement Learning for Vision-Based Dexterous Manipulation on Humanoids. CoRL 2025. arXiv:2502.20396 · Project.
Hsieh et al. Learning Dexterous Manipulation Skills from Imperfect Simulations (DexScrew). 2025. arXiv:2512.02011 · Project · Code.
Yin et al. Emergent Dexterity via Diverse Resets and Large-Scale Reinforcement Learning (OmniReset). ICLR 2026. arXiv:2603.15789 · Project · Code.
A Balanced Data Diet: Addressing the Exploration Bottleneck in Mega-Scale RL for Robot Control (SGS). CoRL 2026. arXiv:2610.12465 · Project.
Beukman et al. Preventing Learning Stagnation in PPO by Scaling to 1 Million Parallel Environments. RLC 2026. arXiv:2603.06009.
Mandi et al. DexMachina: Functional Retargeting for Bimanual Dexterous Manipulation. ICML 2026. arXiv:2505.24853 · Project · Code.
Kedia et al. SimToolReal: An Object-Centric Policy for Zero-Shot Dexterous Tool Manipulation. 2026. arXiv:2602.16863 · Project · Code.
Lum et al. Play2Perfect: What Matters in Dexterous Play Pretraining for Precise Assembly? 2026. arXiv:2606.26428 · Project · Code.
Paliwal et al. Do as I Do: Dexterous Manipulation Data from Everyday Human Videos. 2026. arXiv:2606.19333 · Project · Code.
Li et al. Towards Human-level Dexterous Teleoperation (TeleDexter). 2026. arXiv:2607.11481 · Project.
Gupta et al. EigenDEXplore: Structured Exploration for Dexterous Manipulation with Human Priors. 2026. arXiv:2610.07681 · Project · Code.
Kuang et al. AdaDex: Learning Adaptable Dexterous Skills via Hybrid Dexterous Mimicking. 2026. arXiv:2610.28628 · Project.
Sun et al. DONIC: Generalist Dexterous Bimanual Tracking Control from Human Demonstrations. 2026. arXiv:2610.29997 · Project · Code.
Pan et al. SPIDER: Scalable Physics-Informed Dexterous Retargeting. 2025. arXiv:2511.09484 · Project · Code.
图片均取自所引用论文,版权归原作者所有。