他山之石,可以攻玉。
— 《诗经·小雅·鹤鸣》说明:这篇 blog 在 AI 的辅助下完成。
四类方法
| 方向 | 做法 | 相关工作 |
|---|---|---|
| 把 PPO 的 batch 用对 | batch = 环境数 × 每环境步数。还要看重置是否同步,以及 minibatch 和学习率是否随环境数调整。改动最便宜,也最常做错。 | Rudin · Andrychowicz · DD-PPO · Mayor · Staggered Resets · Hilton · Beukman |
| 多策略:用种群换多样性 | 一张卡上同时训练几个到几十个策略,互相借数据,或者定期淘汰差的、变异好的。买的是探索的多样性,代价是更多算力和代码复杂度。 | DexPBT · SAPG · EPO |
| 改起点:重置分布与课程 | 让难的状态直接出现在 batch 里:从生成的抓取态、演示的中间态或接近目标的状态开始回合,再按成功率挑起点。对长程接触任务效果最大。 | OmniReset · SGS · DemoStart · RFCL · DextrAH-G/RGB · CSRL |
| off-policy 在海量并行下复活 | 用回放池重复利用数据,配上大 batch、分布式 critic 和归一化,让 SAC/TD3 在几千个环境下比 PPO 更快。 | PQL · PQN · FastTD3 · FastSAC · FlashSAC/WarpSAC · REPPO |
相关工作的时间线
- DD-PPO
- Hilton (PPO-EWMA)
年份按会议年份,没有会议的按 arXiv 年份。
1. On-Policy,优化 batch
[CoRL'21] Learning to Walk in Minutes Using Massively Parallel Deep Reinforcement Learning
Comment: 大名鼎鼎的rsl_rl/legged_gym出处
代码:legged_gym, rsl_rl
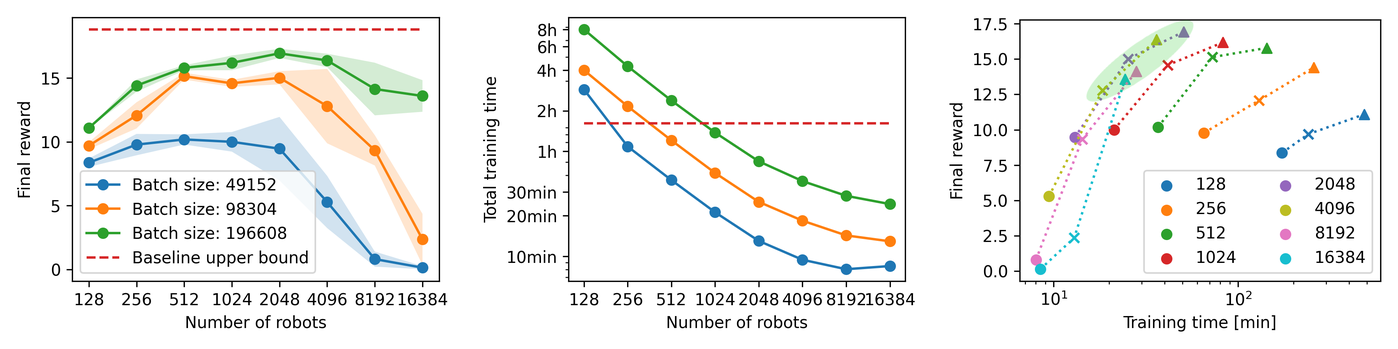
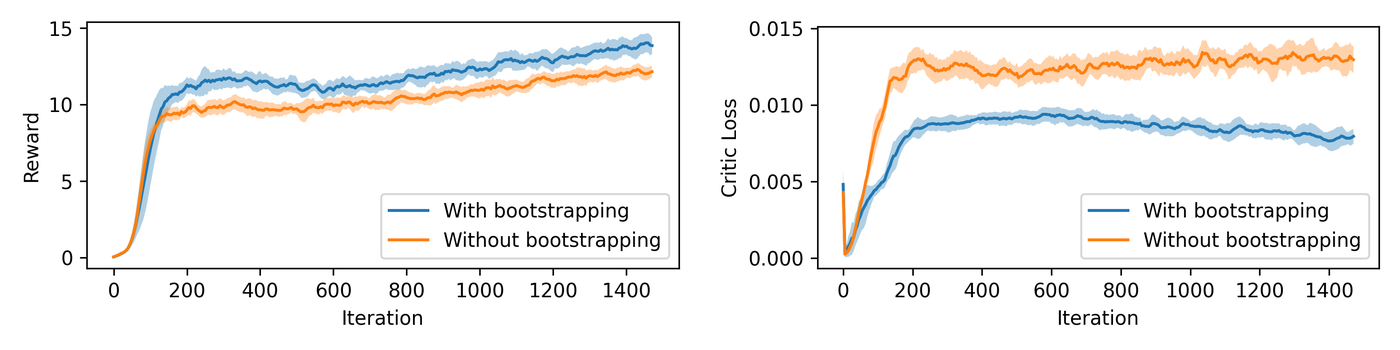
核心结论
大 batch size,大 \(N_{\mathrm{env}}\)
超时截断应该做 value bootstrapping
[ICLR'22] What Matters In On-Policy Reinforcement Learning? A Large-Scale Empirical Study
核心结论
trick小合集,没有什么特别的结论。
[ICML'25] The Impact of On-Policy Parallelized Data Collection on Deep Reinforcement Learning Networks
论文: arXiv:2506.03404
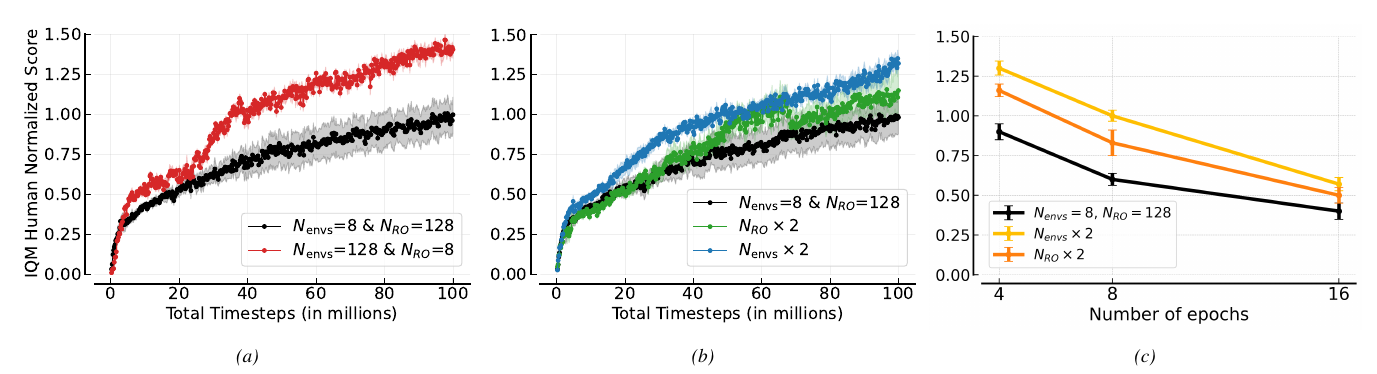
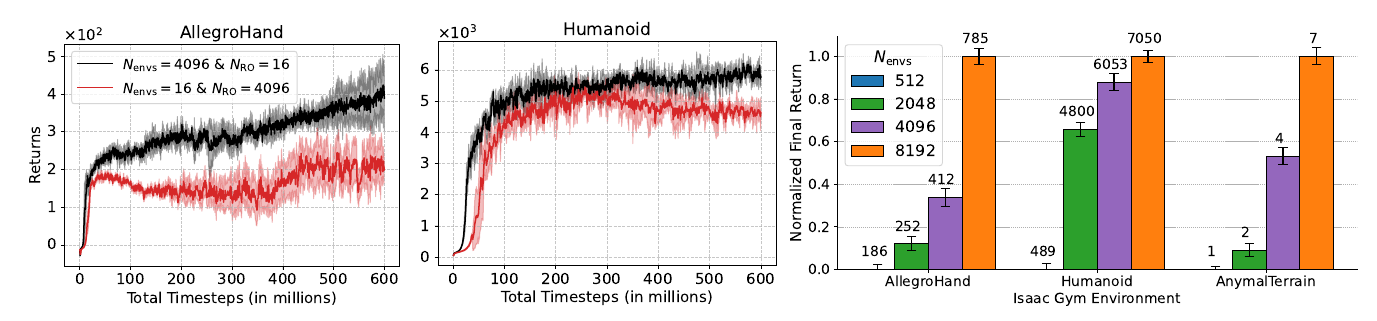
核心结论
并行 on-policy RL 里,batch 大小 \(|B| = N_{\mathrm{envs}} \times N_{\mathrm{RO}}\)。其中用更多环境,更少 rollout length比反之更好
[NIPS'25] Staggered Environment Resets Improve Massively Parallel On-Policy Reinforcement Learning
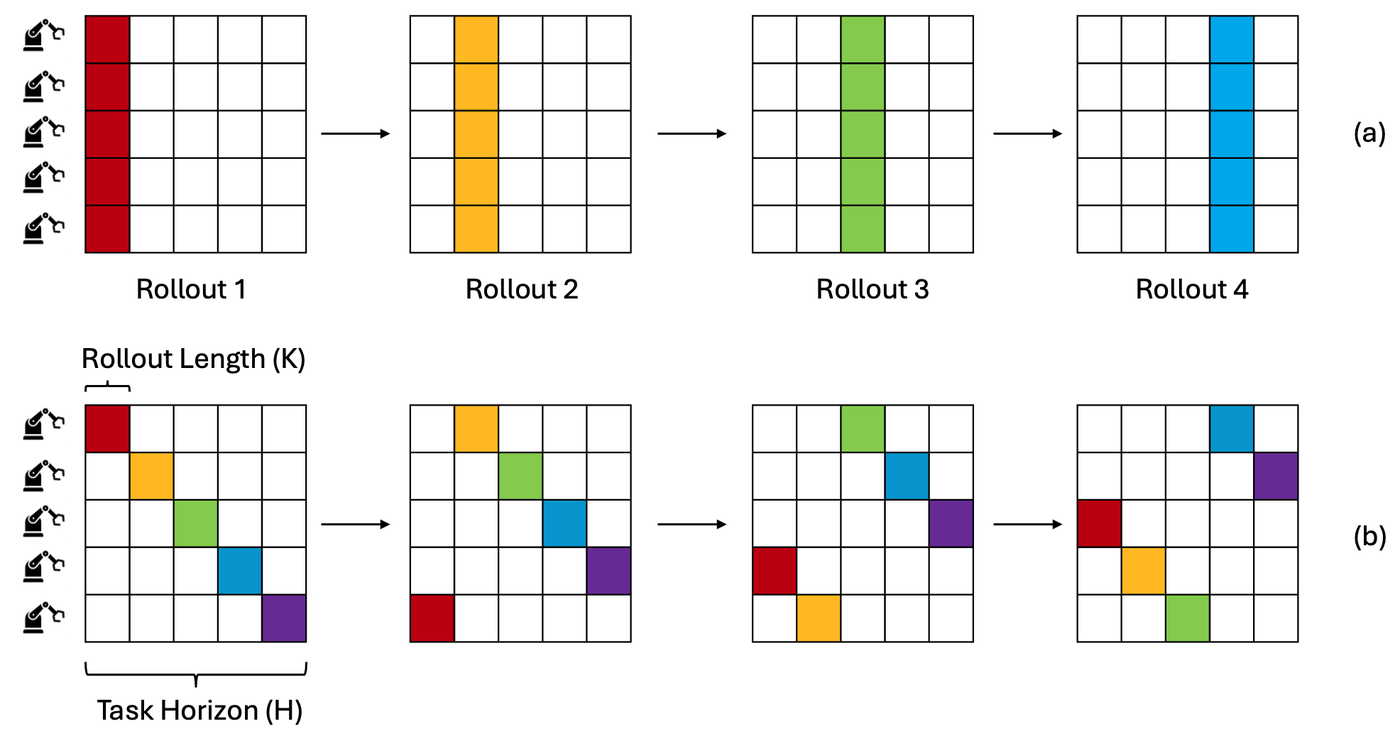
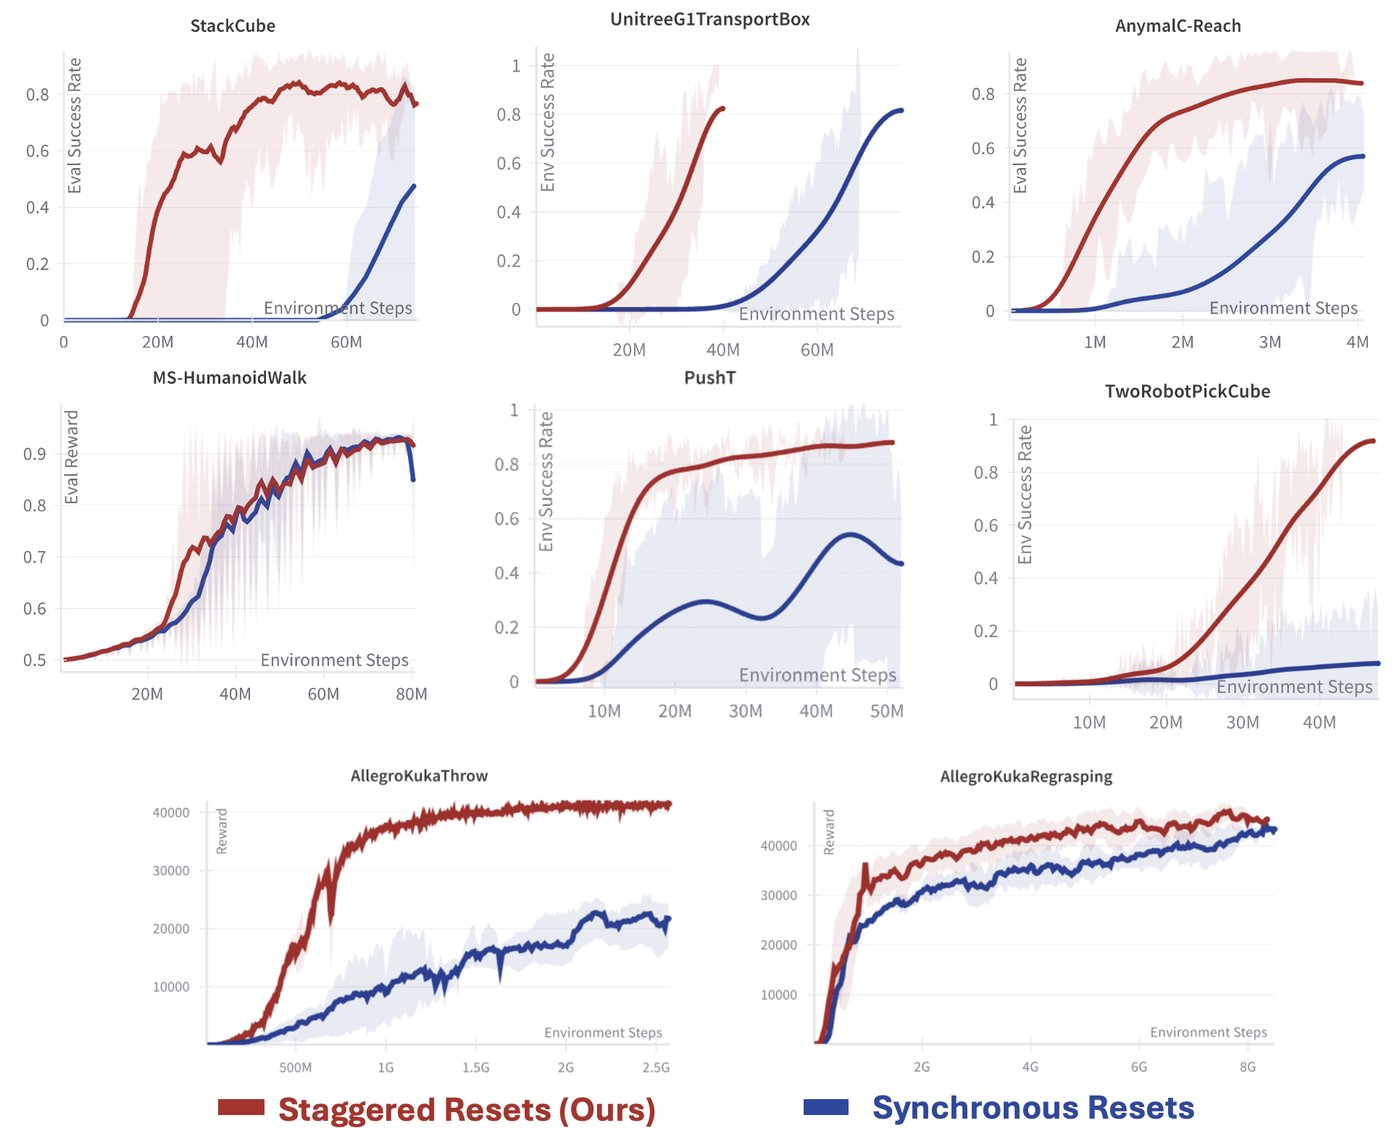
但如果所有环境同时在 t=0 开始、同时在 t=H 超时重置,第 j 次更新的 batch 就只包含 \([(j-1)K, jK-1]\) 这一小段时间窗的状态:一批全是"刚开局",下一批全是"抓取中",……过 \(\lceil H/K \rceil\) 次更新后又全部跳回开局。作者称之为周期性批次非平稳(cyclical nonstationarity)。后果是 critic 一直在追一个循环变化的数据分布,学了后段忘了前段(灾难性遗忘)。
核心结论
应该初始reset的时候就把distribution错开
2. On-Policy,优化怎么用这个 fleet
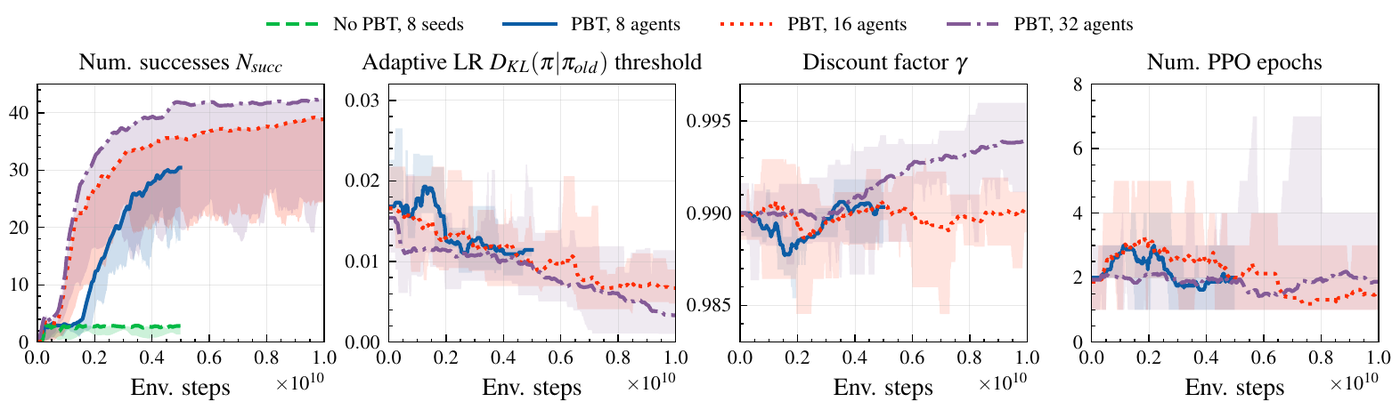
[RSS'23] DexPBT: Scaling up Dexterous Manipulation for Hand-Arm Systems with Population Based Training
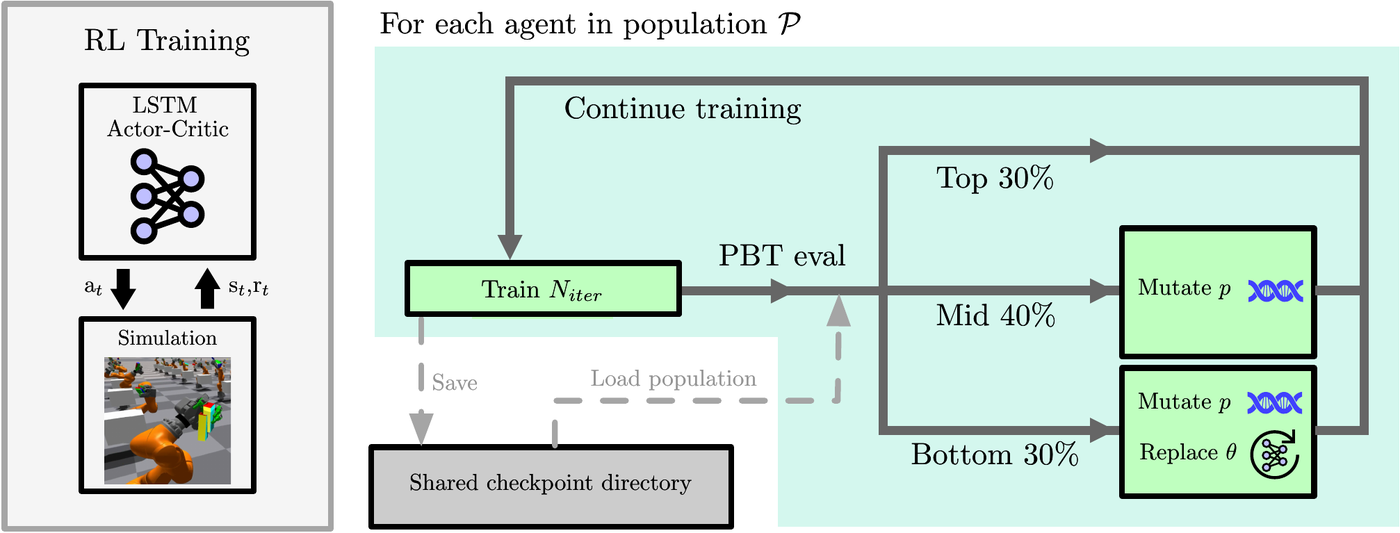
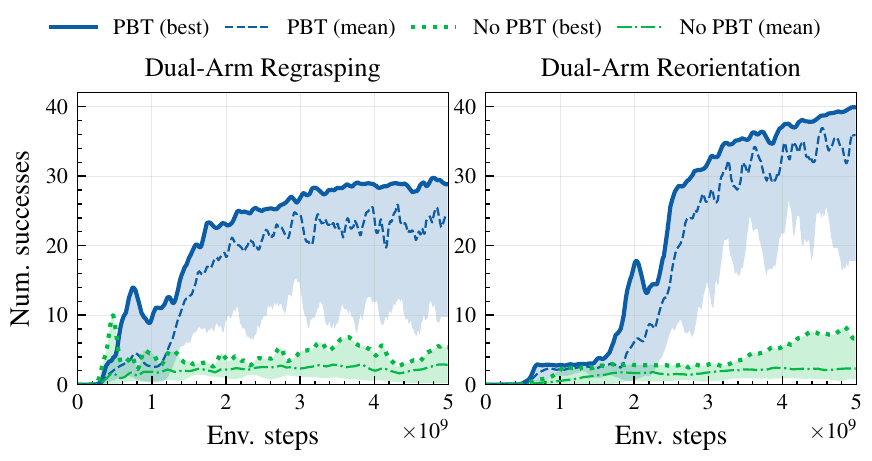
手臂+多指手的任务探索难,同时跑 8–32 个 PPO 训练(每个占一张 GPU、各 8192 个环境),定期把差的复制成好的、并随机扰动超参数和奖励系数,用"种群 + 进化"来解决高维灵巧操作里 PPO 单次运行容易卡在局部最优的问题。
核心结论
PPO 是抽奖,尤其是高维度 task,多抽抽奖然后把 work 的多铺开(外环类似遗传算法)。
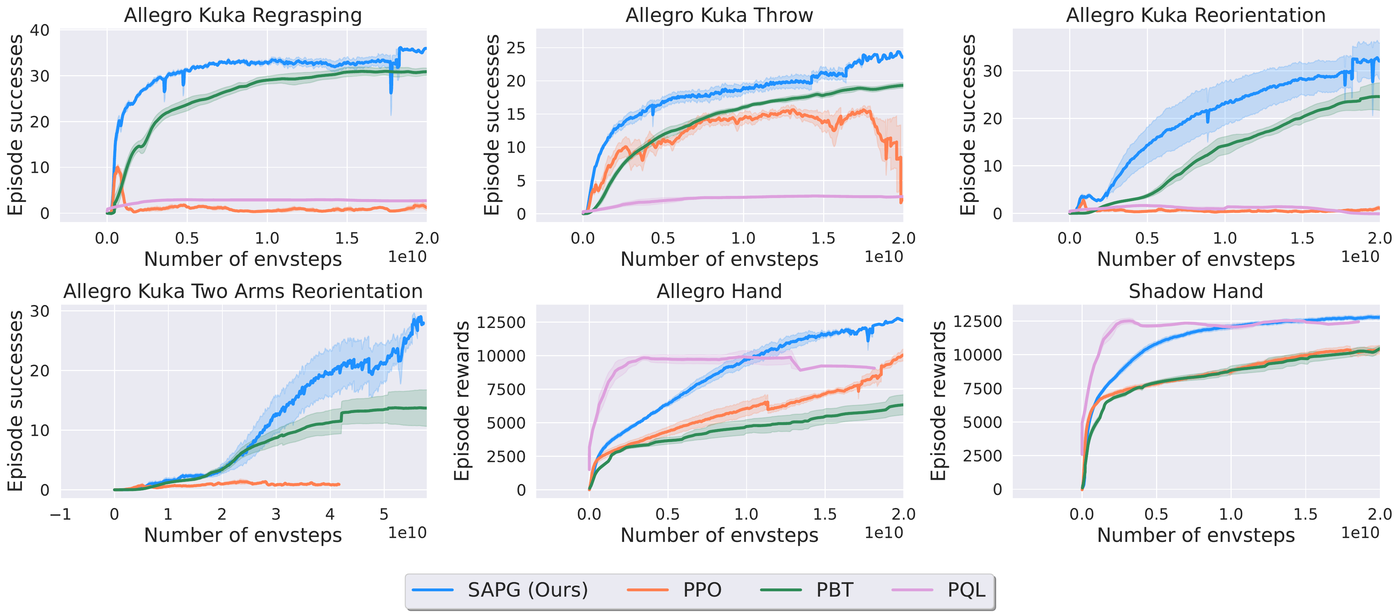
[ICML'24] SAPG:Split and Aggregate Policy Gradients
论文:arXiv:2407.20230 代码:sapg
PPO 的 \(N_{\mathrm{env}}\) 大到一定程度之后,batch size 增大到一定程度就饱和了 (蓝:PPO, 红: SAPG)
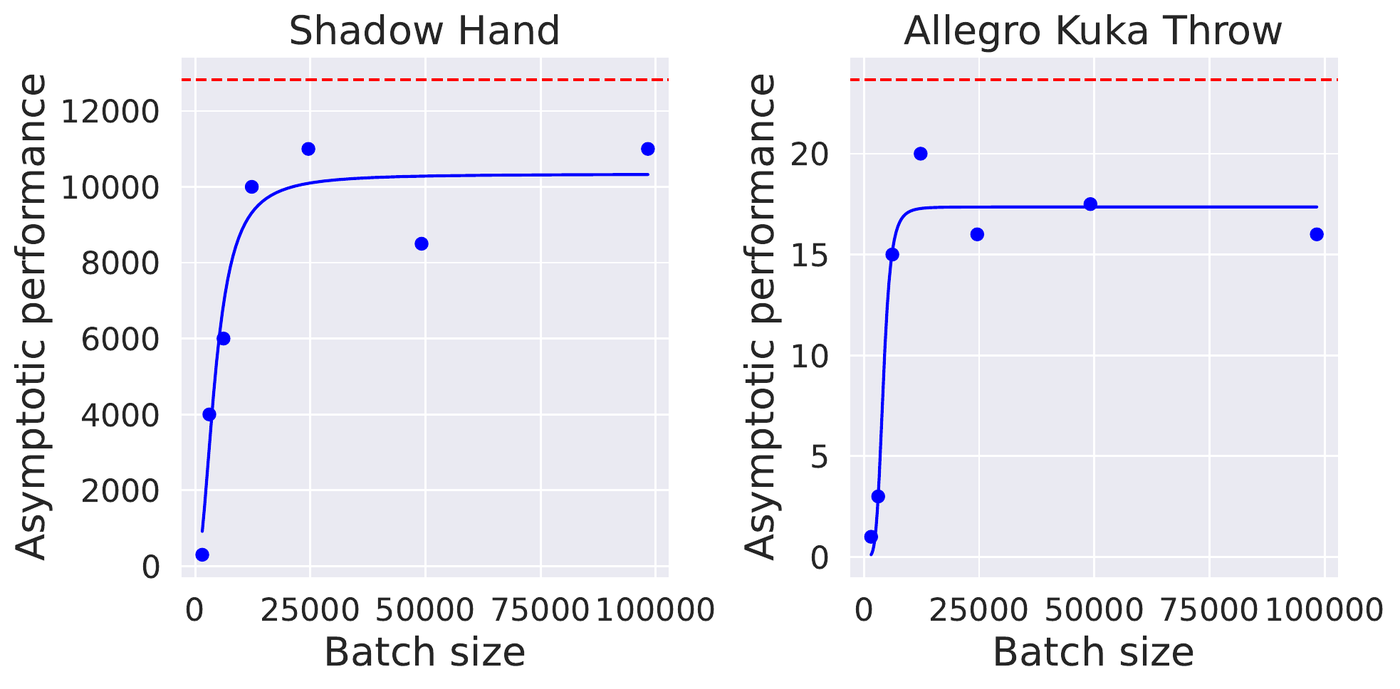
作者给的解释是:所有环境都从同一个高斯策略采样,动作大多落在均值附近,环境越多,重复数据越多,“多出来的环境被浪费了”
方法:
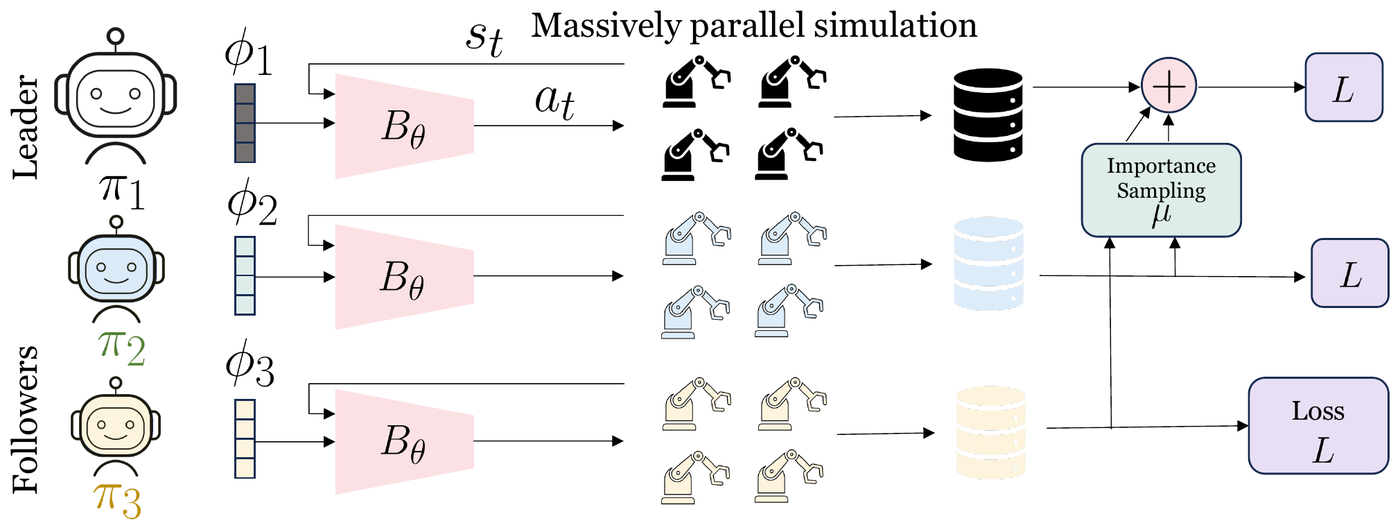
拆分:N 个环境平均分给 M 个策略 \(\pi_1\ldots\pi_M\)(论文用 M=6、N=24576,即每个策略 4096 个环境)。所有策略共享 actor 主干 \(B_\theta\) 和 critic 主干 \(C_\psi\),第 j 个策略额外有一个只属于自己的可学习向量 \(\phi_j\)(复杂任务 \(\phi_j\in\mathbb R^{32}\),简单任务 \(\mathbb R^{16}\)),作为网络输入条件。\(\phi_j\) 只被自己的损失更新,\(\theta/\psi\) 被所有损失更新。
leader–follower 聚合:\(\pi_1\) 是 leader,\(\pi_2\ldots\pi_M\) 是 follower。
follower:只用自己块内的 on-policy 数据做普通 PPO。
leader:on-policy PPO 损失 + \(\lambda\cdot\)off-policy 损失,\(\lambda=1\)。off-policy 数据从 follower 的数据并集中下采样到与 leader 自己的数据同样多(\(|D'_1|=|D_1|\)),避免噪声更大的 off-policy 梯度淹没 on-policy 梯度。
off-policy 截断代理目标(来自 Meng et al. 2023 的 off-policy PPO):
\[ \begin{aligned} L_{\mathrm{off}}(\pi_i;X) &= \frac{1}{|X|}\sum_{j\in X}\mathbb E_{(s,a)\sim\pi_j} \left[\min\left(rA, \operatorname{clip}\left(r,\mu(1-\epsilon),\mu(1+\epsilon)\right)A\right)\right],\\ r &= \frac{\pi_i(a\mid s)}{\pi_j(a\mid s)},\qquad \mu = \frac{\pi_{i,\mathrm{old}}(a\mid s)}{\pi_j(a\mid s)}. \end{aligned} \]把 clip 区间以“旧策略相对于行为策略的比值”为中心平移,\(A\) 是 leader 旧 critic 估计的优势。当 \(j=i\) 时退化为普通 PPO。
critic:on-policy 数据用 3-step return 目标,off-policy 数据只用 1-step 目标:
\[ \begin{aligned} V^{\mathrm{tgt}}_{\mathrm{on}} &=\sum_{k=t}^{t+2}\gamma^{k-t}r_k+\gamma^3V_{\mathrm{old}}(s_{t+3}),\\ V^{\mathrm{tgt}}_{\mathrm{off}} &=r_t+\gamma V_{\mathrm{old}}(s_{t+1}). \end{aligned} \]总 critic 损失 = on + \(\lambda\cdot\)off。
多样性:除了 \(\phi_j\) 条件化,可选给 follower 加不同强度的熵正则:第 i 个策略的熵系数 = \(\lambda_{\mathrm{ent}}(i-1)\),leader 不加熵;此时每个块有自己的可学习 σ 向量。\(\lambda_{\mathrm{ent}}\) 从 \(\{0,0.003,0.005\}\) 中挑(Reorientation、ShadowHand 用 0.005,其余 0)。
每次迭代:所有块各 rollout 16 步(AllegroKuka)→ 拼成一个总损失 → 对 θ, ψ, φ 一起做梯度步(Algorithm 1)。
核心结论
在 on-policy 算法中避免重复采样能提升策略表现。
[arxiv'25] EPO:Evolutionary Policy Optimization
代码:EPO
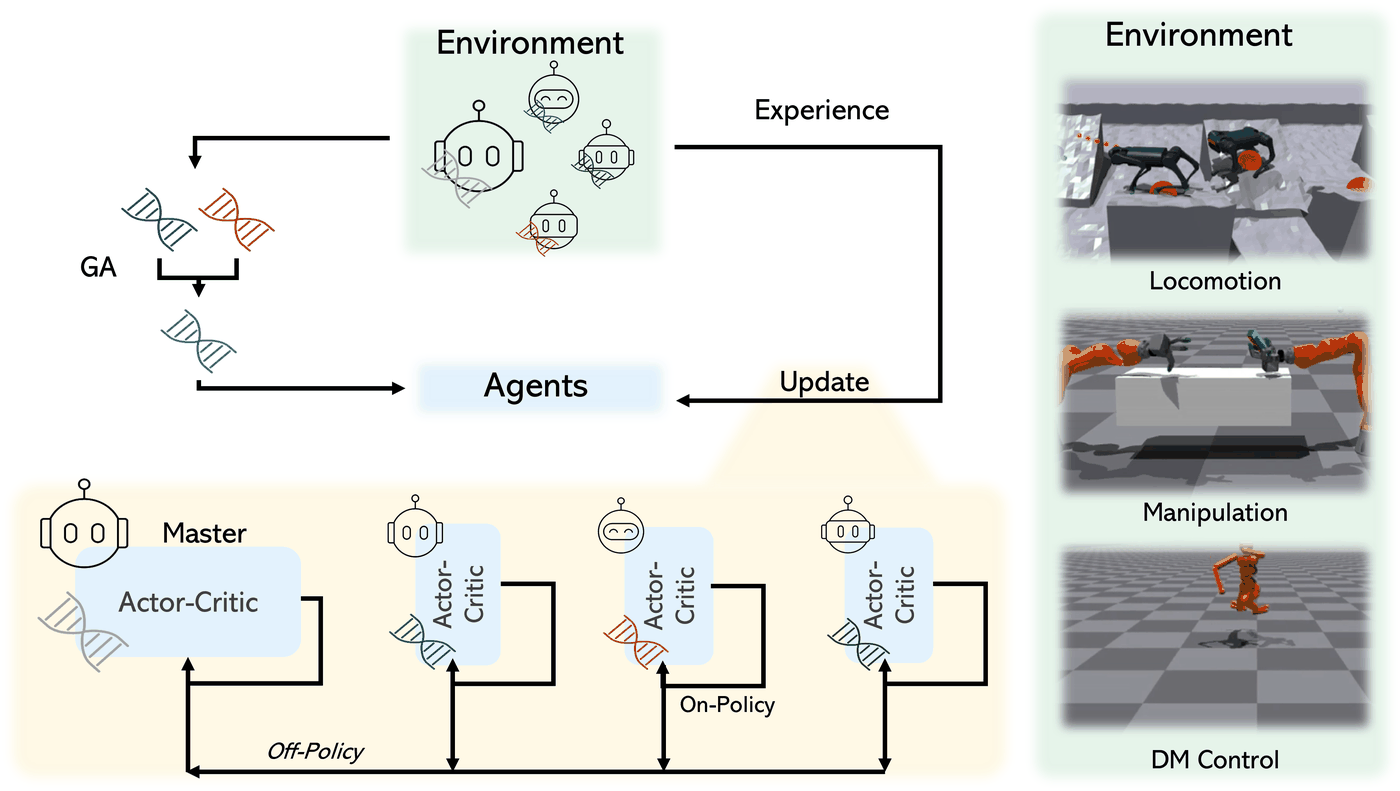
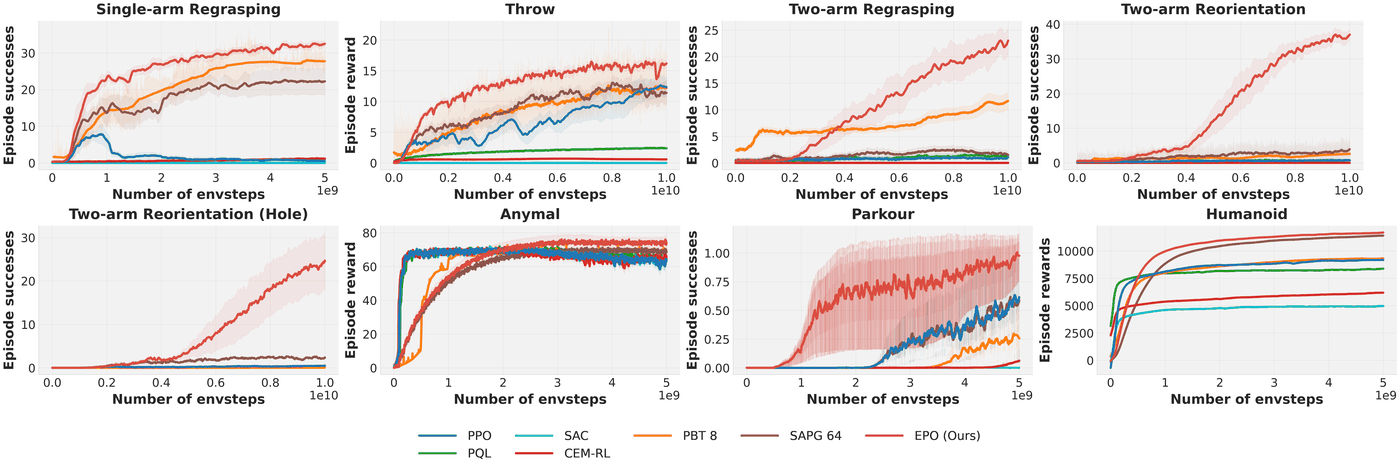
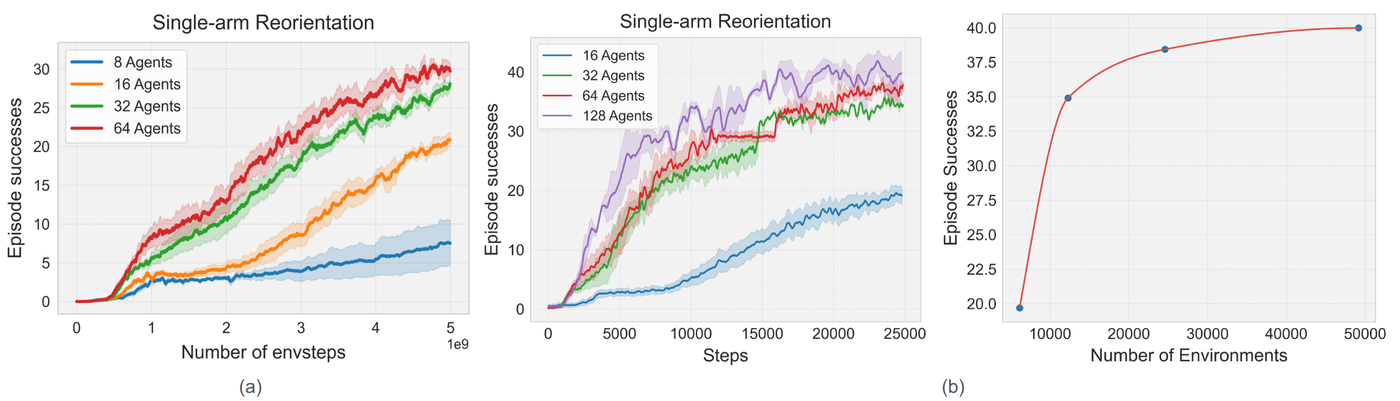
在 SAPG 的"leader 吸收 follower 数据"框架上,把 follower 数量扩到 64 个,并对 follower 的潜变量 φ 做遗传算法(淘汰差的、交叉+变异好的),让"多策略"能随环境数一起扩展。
3. On-Policy,优化怎么做 reset
[ICLR'26] OmniReset
论文: arXiv:2603.15789
代码:UWLab
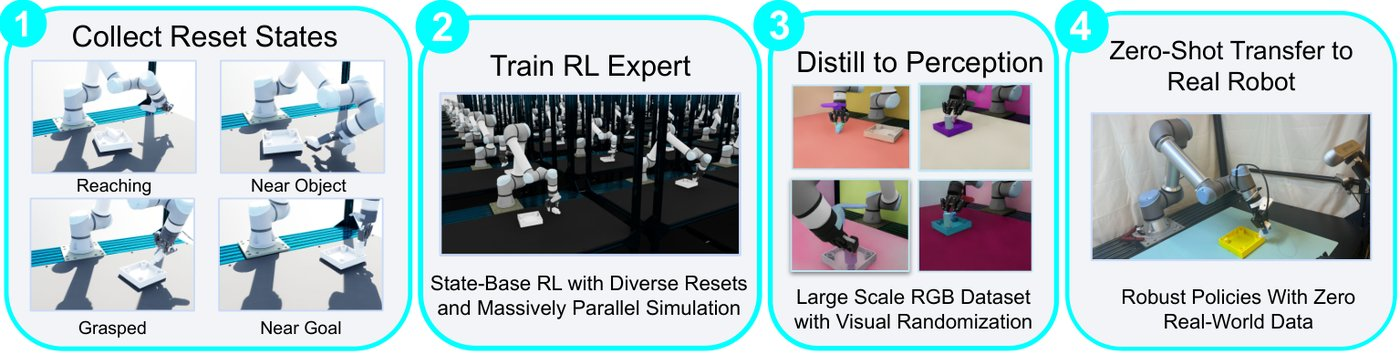
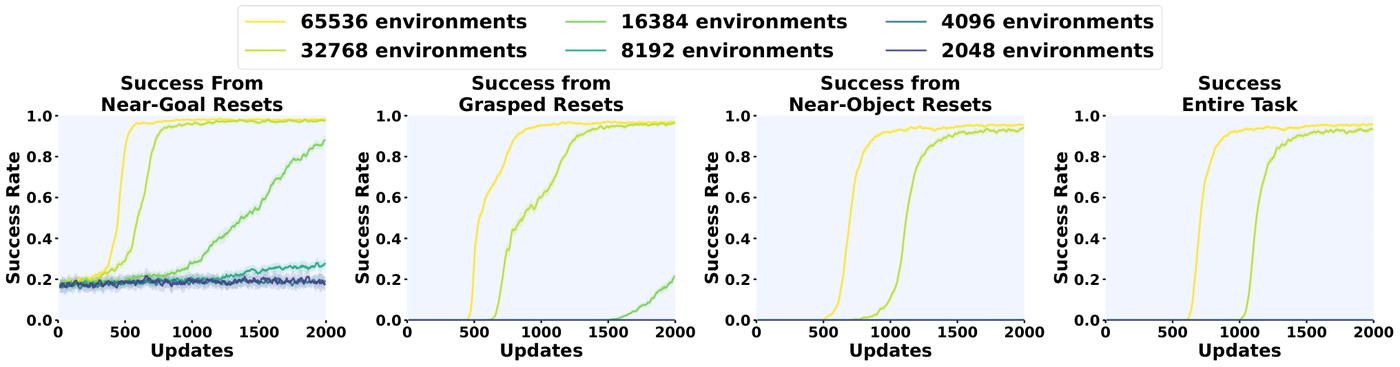
标准 PPO 在大规模并行下会「饱和」——env 再多,也只是在同一片狭窄状态区域里重复采样,长程任务里成功信号太稀有,策略困在局部最优(如只学会伸手)。
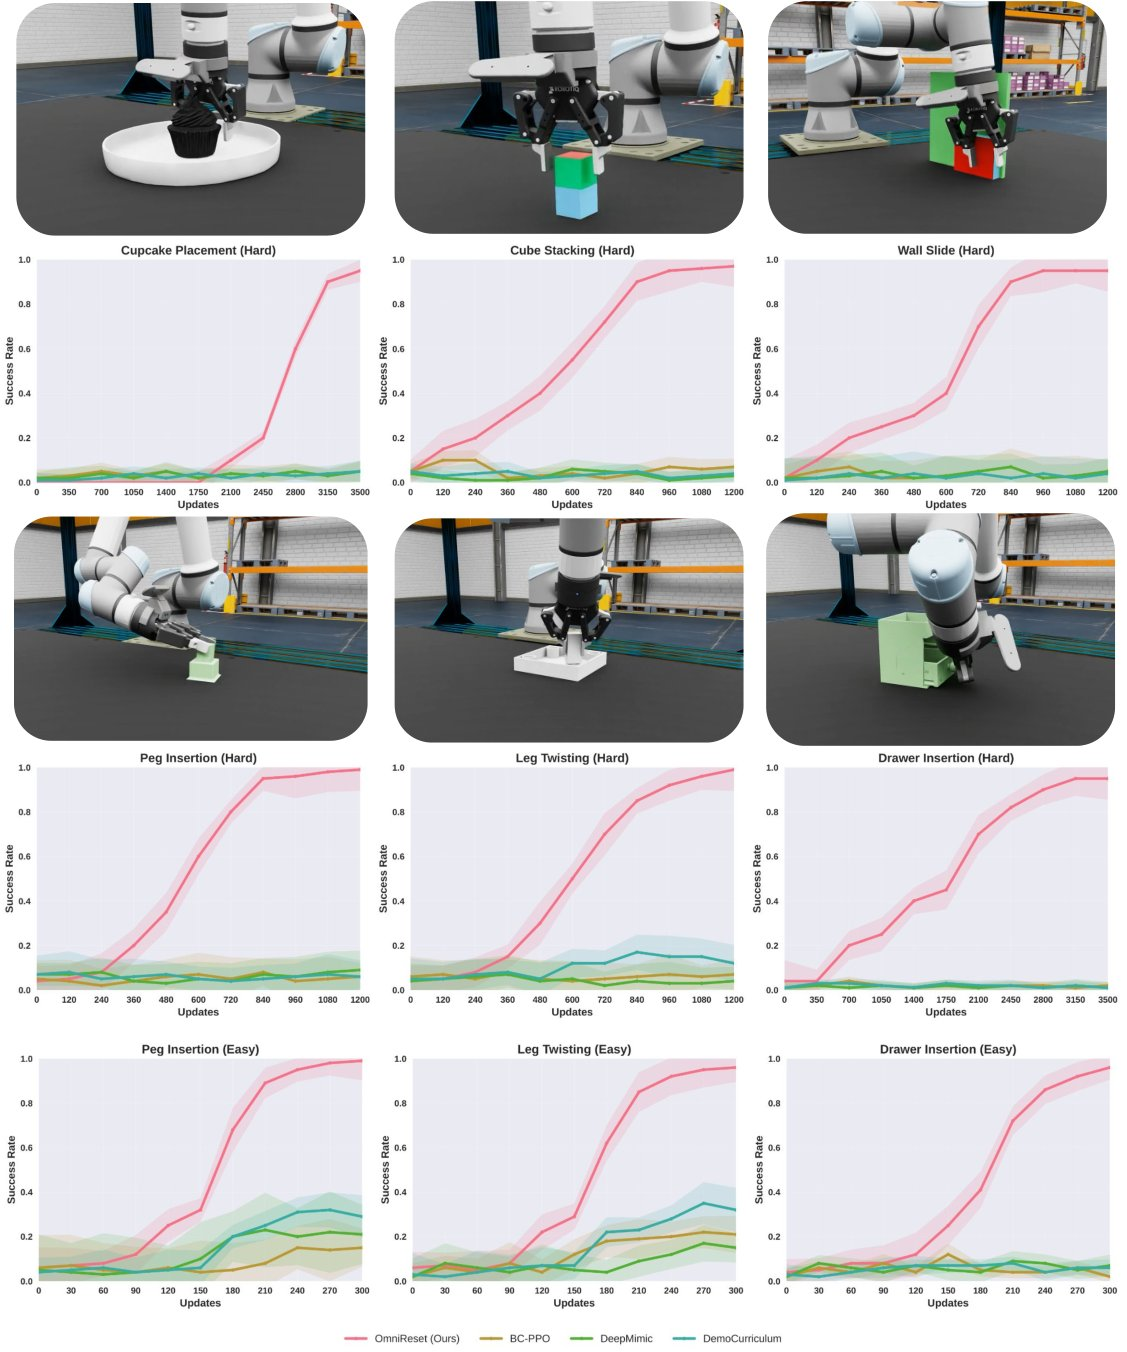
方法:程序化生成的多样重置状态 + 大量并行 env 的 PPO
核心结论
大N_env是对的,避免重复采样是对的,通过手动调整reset distribution来去增广coverage/调整buffer里的transition distribution是对的
[CoRL'26] SGS-RL
A Balanced Data Diet: Addressing the Exploration Bottleneck in Mega-Scale RL for Robot Control
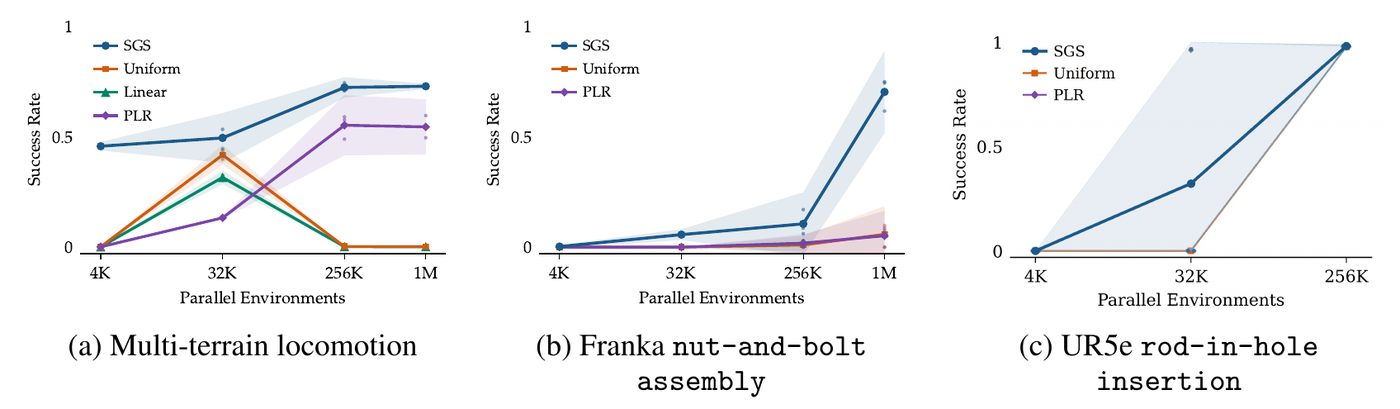
有了 OmniReset 式的多样重置后,均匀采样会把越来越多 env 花在「已经掌握」或「暂时做不到」的配置上,这些配置对 PPO 梯度没有贡献(优势函数接近 0)。env 越多,浪费的绝对量越大,所以「加 env」的收益消失甚至变差。
Related: DemoStart Demonstration-led auto-curriculum applied to sim-to-real with multi-fingered robots (arXiv:2409.06613) 是从demonstration start的地方filter掉之前从这里开始的全成功/全失败,是一个这个idea在另一个problem setup下的极端/退化版本。
方法:
训练前从任务分布采一个固定集合 N 个配置 \(\tau_i=(s_0,g,e)\)(初始状态、目标、环境);操作任务 N = 32,768,运动 N = 104,000。
每个配置维护最近 H = 100 次的成败(环形缓冲),成功率 \(p_i\) 取均值。
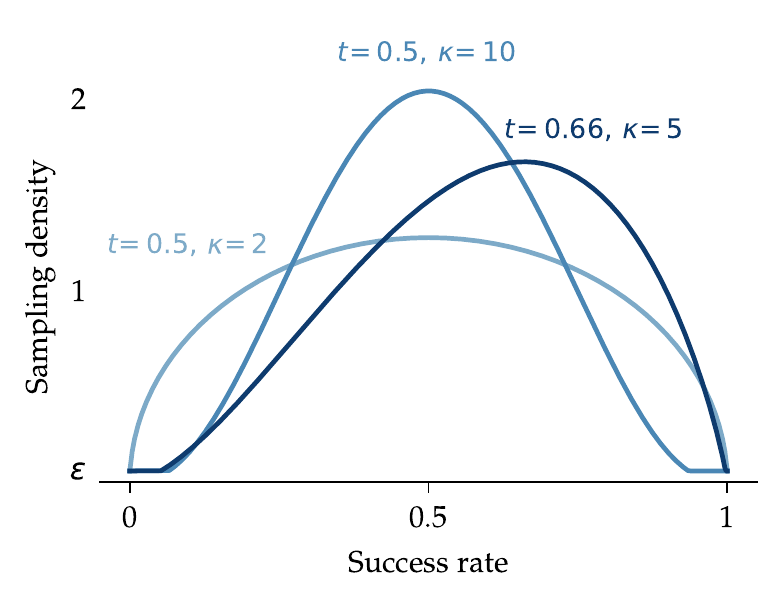
打分(Beta 核的「众数-集中度」形式,目标成功率 t、集中度 κ):
\[ \begin{aligned} w_i&=(p_i+\epsilon)^{\kappa t}(1-p_i+\epsilon)^{\kappa(1-t)},\\ \ell_i&=\log(\max(w_i,\epsilon)+\epsilon). \end{aligned} \]每个 episode 结束时按 softmax 采下一个配置:
\[ p(i)=\frac{\exp(\ell_i/T)}{\sum_j\exp(\ell_j/T)},\qquad T_{\mathrm{eff}}=\max(T,1)\quad\text{(implementation)}. \]超参:H = 100,T = 2;操作任务 t = 0.5, κ = 1, ε = 1e-4;运动任务 t = 0.66, κ = 5, ε = 1e-8。ε 保证每个配置都有非零概率,从而能不断更新成功率估计。
其它配合:每个领域共用一个奖励(终局成功 + 小的正则项);PPO 的 mini-batch 数固定,所以 batch 随 env 数等比例增大。
操作任务的重置池沿用 OmniReset 三类:Reaching、Stable Grasp、Near-Goal,各占三分之一,预先碰撞检查。
和已有方法的关系:与 Sampling for Learnability(SFL,按 \(p(1-p)\) 打分)同一思想,区别是滑动窗口成功率、可调目标成功率、所有配置保底概率;对比的 PLR 用 \(|\mathrm{GAE}|\) 作分数。
核心结论
过难/过容易的states都没learning signal,这相当于是adaptive sampling 在难度适中的state上做reset
[CoRL'24] DextrAH-G / DextrAH-RGB
DextrAH-G: Pixels-to-Action Dexterous Arm-Hand Grasping with Geometric Fabrics
- arXiv:arXiv:2407.02274
DextrAH-RGB: Visuomotor Policies to Grasp Anything with Dexterous Hands
arXiv:arXiv:2412.01791
代码:DEXTRAH (「DextrAH on Isaac Lab」,含特权 RL + 在线蒸馏)
臂+多指手的高维动作直接用关节空间 PPO:训练慢、学出不自然的抓法(夹在中指和无名指之间)、多物体根本学不会、真机不安全。
方法:把 23 维关节动作换成 11 维「掌位姿 + 手部 PCA 协同」动作,并负责避碰/关节限位;
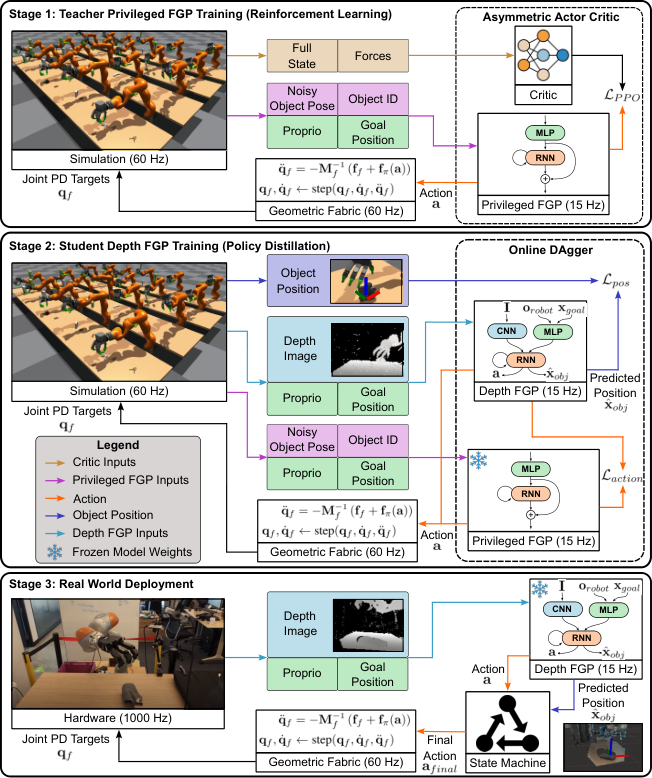
核心结论
高维度动作空间 => 降维度,可以有效提升学习速度, Dexterous Functional Grasping (EigenGrasp https://arxiv.org/pdf/2312.02975 也是类似idea)
后续工作: EigenDEXplore (EigenDEXplore) 使用eigenvectors帮助exploration,稍微constraint soft 一些
4. Off-Policy 罗列
MEGA-Scale目前主要还是on-policy, off-policy最近尤其是在FlashSAC之后让大家开始重新提起兴趣考虑,简单罗列代表性工作和核心insight:
[ICML'23] PQL — Parallel Q-Learning: Scaling Off-policy Reinforcement Learning under Massively Parallel Simulation
把 DDPG 拆成三个并行进程(采数据的 Actor、学 Q 的 V-learner、学策略的 P-learner),在单台工作站上让 off-policy 吃满上万个 Isaac Gym 环境,墙钟时间比 PPO 快、样本效率也更高。
arXiv:arXiv:2307.12983
代码:pql
核心结论
每个 env 用不同探索强度可以试试,
[ICLR'25] PQN: Simplifying Deep Temporal Difference Learning
arXiv: arXiv:2407.04811
代码: purejaxql
证明 LayerNorm(+ 少量 ℓ2)能让 TD 学习在无目标网络、无回放池时也收敛;于是把 DQN 简化成「大量并行 env + 小段 λ-回报 + 像 PPO 一样分 mini-batch 更新」的纯 GPU Q 学习。
核心结论
layernorm, lambda-回报都挺重要
[arxiv'25] FastTD3: Simple, Fast, and Capable Reinforcement Learning for Humanoid Control
arXivarXiv:2505.22642
代码FastTD3
不发明新东西,把 PQL 的经验做成一个同步、简单、调好参数的 TD3:并行仿真 +超大 batch(32768)+ categorical critic + CDQ,单张 A100 3 小时内解 HumanoidBench 多数任务,并支持 IsaacLab / MuJoCo Playground。
核心结论
大batch和categorical critic是对的
[arxiv'25] FastSAC: Learning Sim-to-Real Humanoid Locomotion in 15 Minutes
arXivarXiv:2512.01996
代码holosoma
把 FastTD3 论文里不稳定的 FastSAC 调稳,配合极简奖励,在单张 RTX 4090 上 15 分钟训出带强域随机化、可上真机的 G1/T1 全身(29 自由度)行走策略;全身动作跟踪用 4×L40S、16384 env 也比 PPO 快。
核心结论
LayerNorm,取 Q-mean 而不是 CDQ,自动 alpha。
[RSS'26] FlashSAC: Fast and Stable Off-Policy Reinforcement Learning for High-Dimensional Robot Control
arXiv:arXiv:2604.04539
代码:FlashSAC
核心结论
用更大的网络(2.5M 参数、6 层)、更大 batch、更大回放池、更少的梯度更新(UTD = 2/1024),再用 BatchNorm/RMSNorm/权重投影/分布式 critic 把各种范数约束住,让 SAC 在高维任务上既快又稳。
后续工作: WarpSAC: Towards the Pinnacle of Scalable Off-policy RL by Rethinking Exploration and Exploitation
arXiv:arXiv:2608.24479
代码:warprl
核心结论
GPU 大规模并行时关掉权重投影归一化、只用单个 Q 反而更好