说明:这篇 blog 在 AI 的辅助下完成。
我会先看什么
核心判断
读完这几家的报告,我觉得 Robo VLM 的配方已经相当接近:在通用 VLM 上继续训,把框、点、轨迹统一成 0–1000 坐标文本;用"开源数据 + 几何真值规则生成 + 视频自动挖 + 强 VLM 校验"造数千万条数据。HY、RynnBrain 和 GroundingPI 还会用可验证奖励做 GRPO;RoboBrain 2.5 这里主要讨论的是两阶段监督训练。各家差别主要在数据押注的能力,而不在模型结构。四家都发布了权重,也都有值得在单张 5090 上尝试的版本;实际显存还取决于量化、上下文长度和视频帧数。
HY-Embodied(腾讯):数据工程最系统。感知数据前置到预训练(检测 62M、深度 36M),按能力分类配比,后训练用 RL → 拒绝采样 → 再 RL 自进化。数据不开源。
RynnBrain(达摩院):保留基座架构,重点做数据。自采第一人称视频 + SLAM + 人工点选,计划里带坐标。1.1 版加了接触点和 3D 框,并已部署在天机臂 + 无界灵巧手上。发布的权重均为 Apache-2.0,代码和 benchmark 也开放。
RoboBrain(智源):两个表示设计最值得借鉴。(u, v, d) 让 2D 和 3D 轨迹数据可以混训;hop 式进度估计让 VLM 直接变成稠密奖励模型,为此造了约 35M 条进度数据。
GroundingPI(小鹏等):只做 4B 的精确定位基座,34 个 grounding 基准平均 73.68%,高于 GPT-6 Astra 的 71.54%。数据引擎是多教师按字段融合、按任务校验、专家迭代。消融显示密集检测和点选最能迁移到动作。
逼近 Astra:这次读到的工作里,只有 GroundingPI 在感知定位这一项上直接超过了 Astra。在闭环执行上,连 Astra 自己也只完成了 RobotWorld 84 个任务中的 16 个。
Robo-centric VLM 到底输出什么
Robo VLM(也叫具身大脑、embodied foundation model)是在通用多模态大模型上继续训练得到的。它输出的不是动作,而是"动作的前提":哪个物体、在哪里、抓哪里、怎么走、下一步做什么、做到哪一步了。它通常有两种用法:一是作为高层规划器,把带坐标的计划交给底层策略;二是作为 VLA 的初始化主干。HY、RynnBrain、GroundingPI 都用第二种用法做了验证。
Astra 指 OpenAI 的 GPT-6 Astra。公开报道称它在空间推理上有"阶跃式"提升,尤其是 3D 任务。它是闭源的,训练配方没有公开。本文说的"逼近 Astra",指在空间感知、定位、规划、进度判断这些具身能力上追赶闭源前沿。
术语速查:
| 术语 | 意思 |
|---|---|
| grounding / 指代 | 按文字描述在图里画出对应物体的框 |
| pointing / 点选 | 用一个或多个点标出目标,比框更适合表达抓取点和放置位置 |
| affordance / 可供性 | 物体上可以被操作的位置,如把手、按钮、可放置的空区域 |
| trajectory / trace | 末端或物体在图上(或 3D 中)要走的一串路点 |
| 价值 / 进度估计 | 看一帧画面判断任务完成了多少,可以当 RL 的稠密奖励 |
| CoT / 冷启动 | 先用少量带推理过程的数据教模型"先想再答",再做 RL |
| GRPO | 同一题采样多个答案,用组内相对得分估计优势的 RL 算法;本文的 HY、RynnBrain 和 GroundingPI 使用了这类训练 |
| 拒绝采样微调(RFT) | 用模型自己生成、筛选后的正确答案再训练自己 |
从数据到机器人
四家的目标一致:给模型一张图(或一段视频)和一句话,让它用"文字 + 坐标"回答。这些坐标可以是物体框、抓取点、放置点或一串路径点。做法也一致:大量造这种格式的数据,在现成 VLM 上分阶段训练,最后用三种方式接到机器人上。
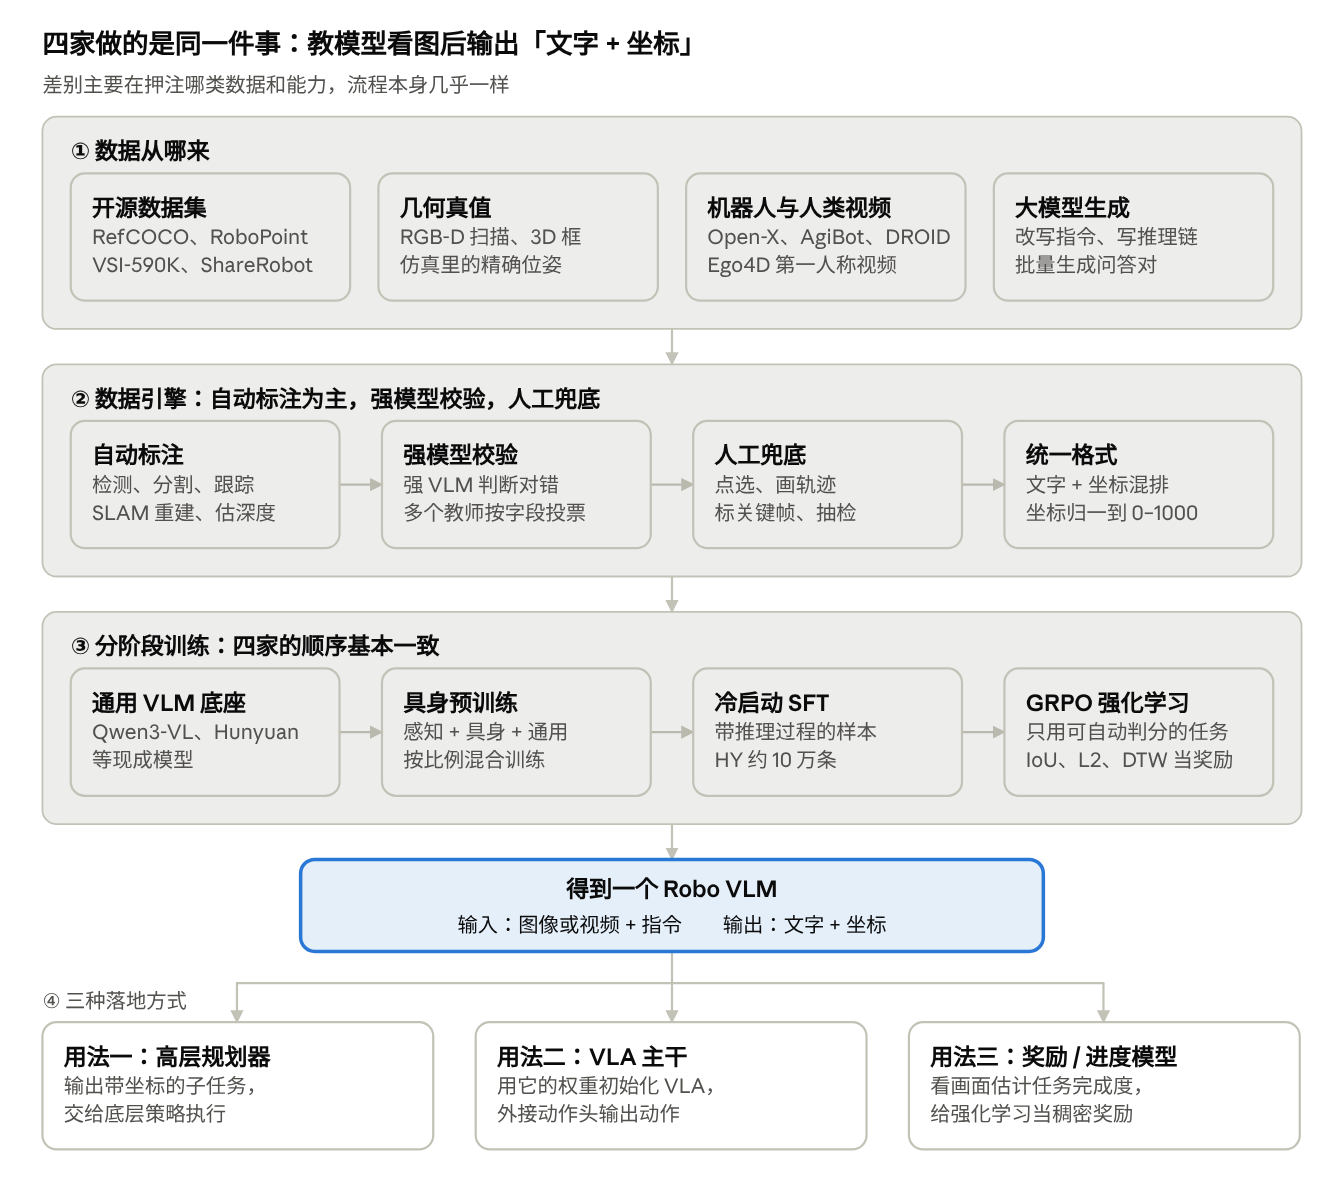
从上往下读:①② 是造数据,③ 是训练,④ 是用。四家的差别不在这张图的结构上,而在每一格里放了什么:HY 在 ③ 里加了"RL → 拒绝采样 → 再 RL"的自进化循环;RynnBrain 在 ① 里自采了大量第一人称视频;RoboBrain 在 ② 里专门造了 3D 轨迹和进度数据;GroundingPI 把 ② 做成了多教师融合的数据引擎,但只管定位。
任务的输入与输出
论文里的"任务"就是一种问答格式。输入都是"图像或视频 + 一句话",区别只在输出是什么:一个框、几个点、一串路径点、一个数,还是一段带坐标的计划。下面 12 张卡片覆盖了四家主要的任务类型。
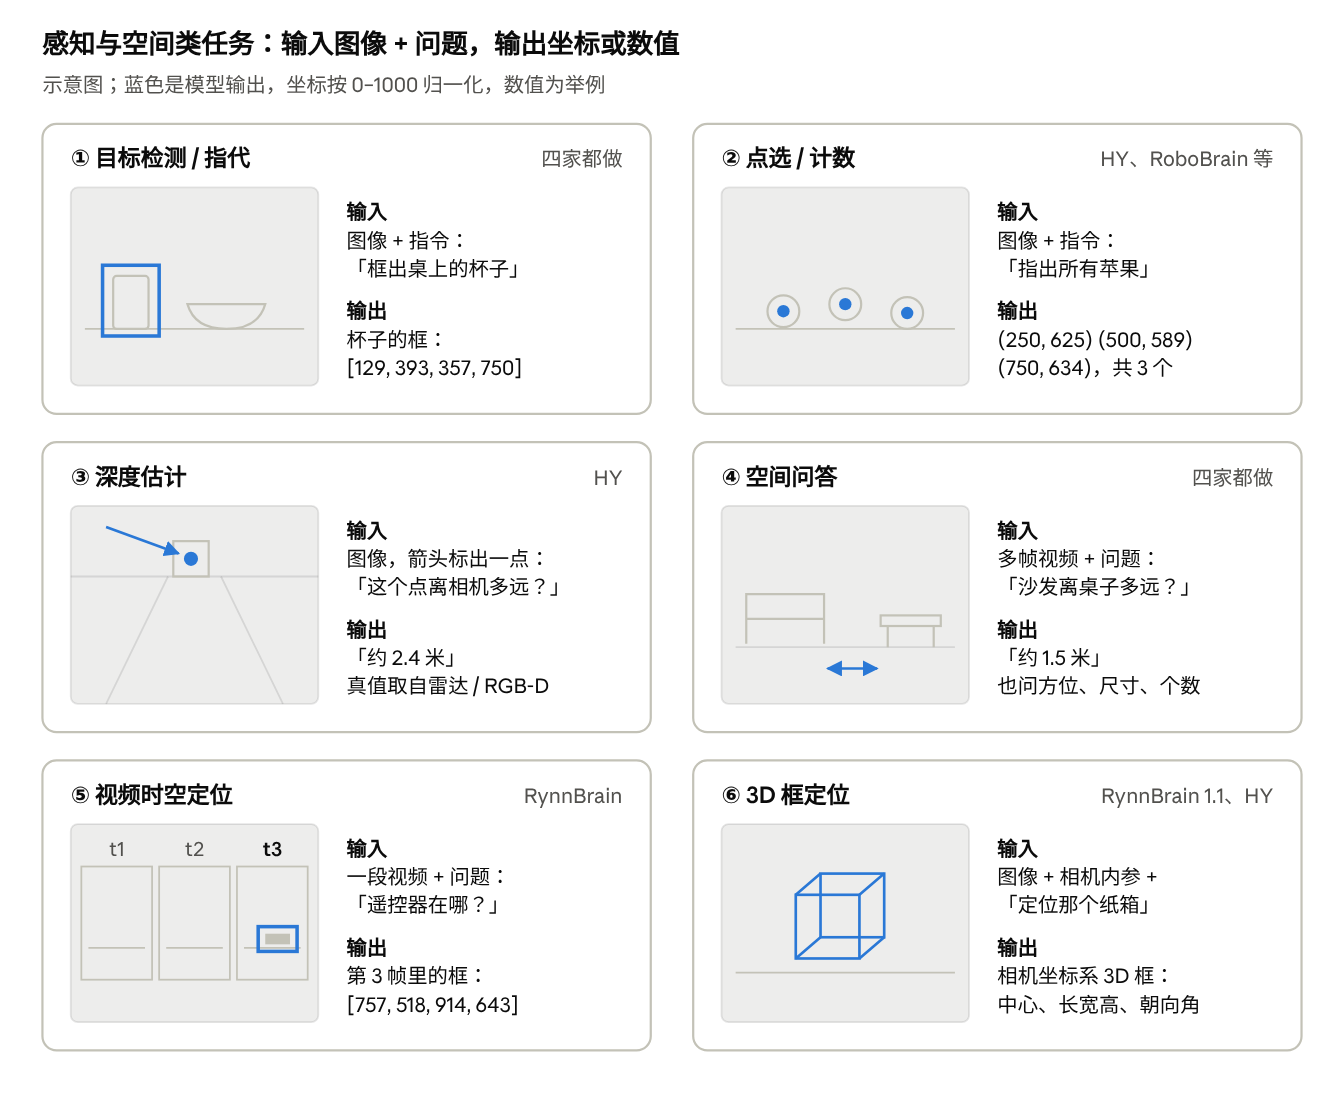
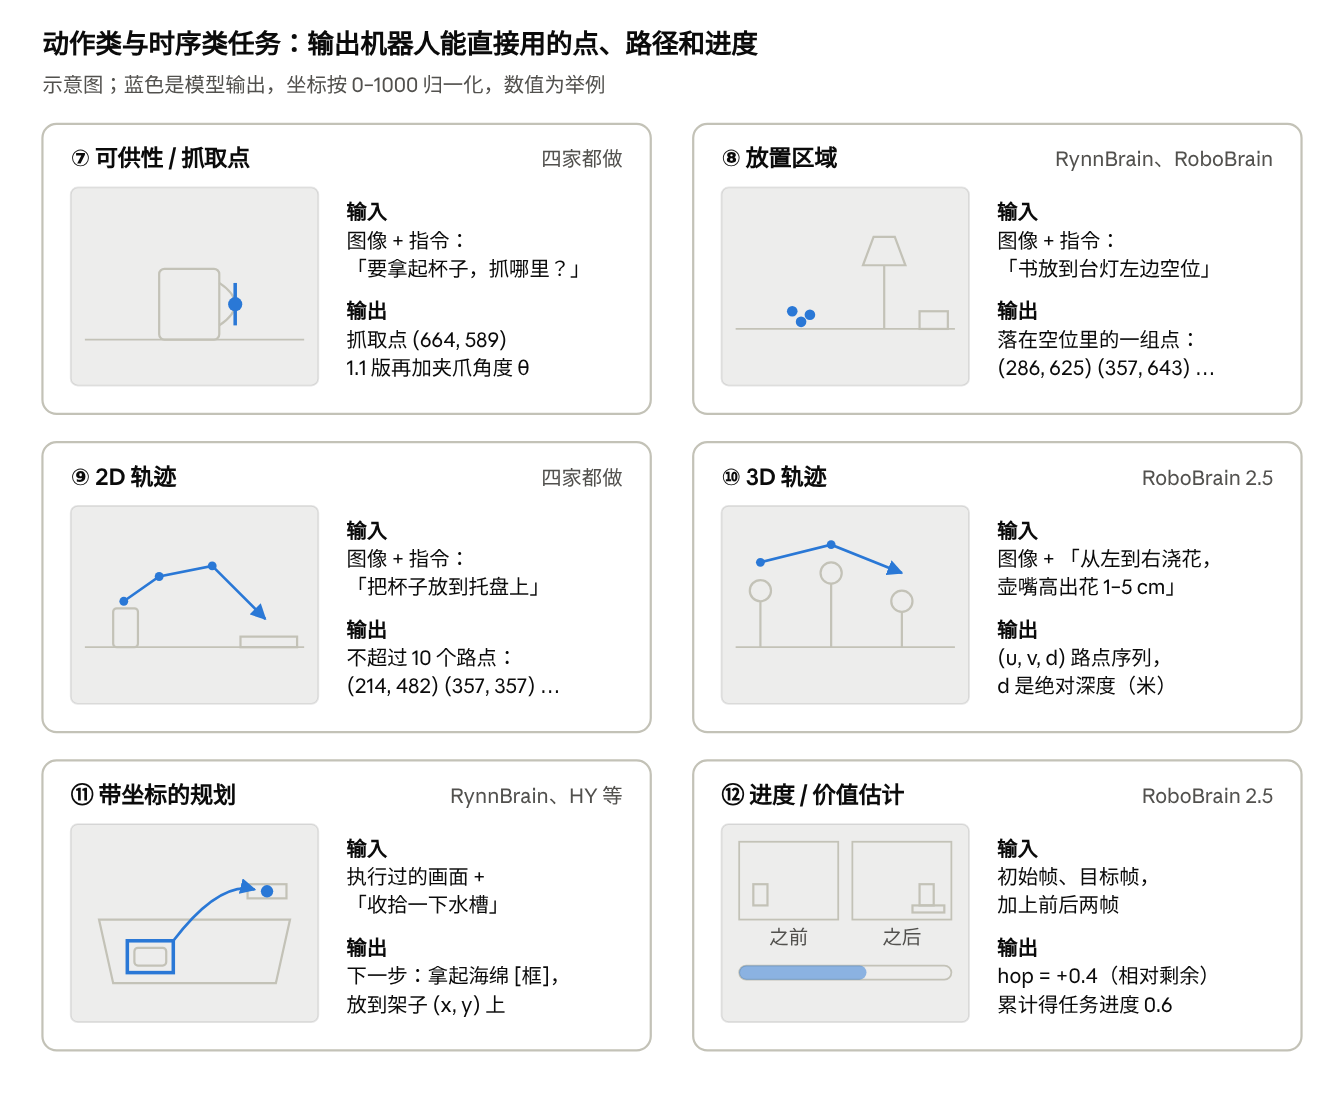
①–⑥ 解决"是什么、在哪、多远",⑦–⑩ 解决"抓哪、放哪、怎么走",⑪⑫ 解决"下一步做什么、做到哪了"。图像坐标通常量化到约 1000 个整数位置,和文字一起作为 token 输出,因此不同任务可以共用一个自回归接口。这里仍要区分图像坐标和度量量:绝对深度保留物理单位,3D 框、掩码也有各自的表示;GroundingPI 用的是 <0>–<999> 专用坐标 token。
三种接法
Robo VLM 自己不输出关节动作,它和机器人之间总要隔一层。三种接法的区别,就是它在控制链路里坐在哪个位置。
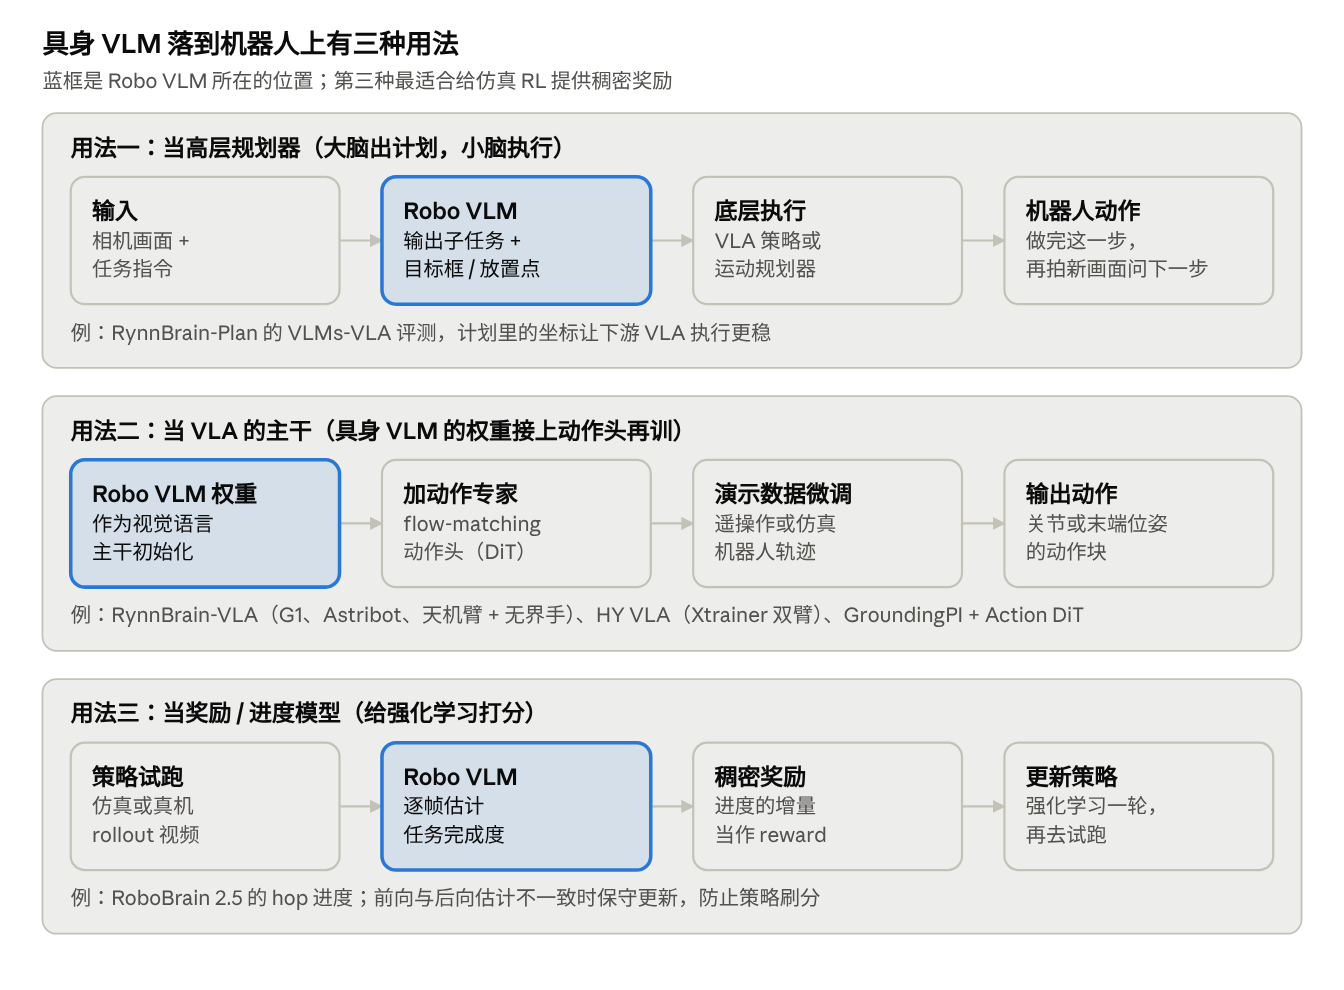
第二种是目前最主流的验证方式:在同样的动作头、同样的演示数据下只换 VLM 主干,看成功率和泛化。GroundingPI 的结论是主干的定位能力越强,少量演示就能学好。每类任务在机器人上的具体用处:
| 任务 | 在机器人上怎么用 |
|---|---|
| ①② 检测、点选 | 告诉策略"操作哪个物体"。GroundingPI 的消融显示,这是对 VLA 迁移最大的能力 |
| ③④⑥ 深度、空间问答、3D 框 | 把"左边 10 cm"“离多远"这类指令变成可执行的度量目标,有内参就能换算到 3D |
| ⑤ 视频时空定位 | 记住"东西在哪一帧见过”,用于找物和导航 |
| ⑦⑧ 抓取点、放置区域 | 直接给出抓哪、放哪,可以交给运动规划器,也可以当 VLA 的条件输入 |
| ⑨⑩ 2D / 3D 轨迹 | 给末端或物体一条参考路径,作为 VLA 的中间表示,或者直接用控制器跟踪 |
| ⑪ 带坐标的规划 | 用法一里规划器的输出格式,一步一步下发给底层策略 |
| ⑫ 进度估计 | 用法三里的稠密奖励;执行中也能判断是否卡住、要不要重试 |
模型与训练配方
HY-Embodied:把感知放进预训练
在预训练阶段就大量灌入感知数据(检测、深度、分割、点选),中期训练再加具身和空间 QA,后训练用"RL → 拒绝采样 → 再 RL"的自进化循环。两代模型:HY-Embodied-0.5(2026-04,MoT-2B / A32B)和 Hy-Embodied-VLM-1.0(2026-07,Hy3-A3B MoE,总参约 30B)。
模型和训练
0.5 版底座是 Hunyuan-1.8B + HY-ViT-2.0(400M)。特点是 Mixture-of-Transformers:视觉 token 和文字 token 走不同参数,另加 latent 视觉 token,预训练时额外用视觉重建损失和全局对齐损失。
流程:预训练(>600B token)→ 具身 / 空间中期训练(约 25–30M 样本,通用 : 具身 : 空间 = 12 : 5 : 3)→ CoT 冷启动 SFT(约 100k)→ GRPO RL → 拒绝采样自进化。小模型最后从 32B 做 on-policy 蒸馏。
1.0 版换成 Hy3-A3B MoE(激活约 3B),预训练数据原样继承 0.5。新增部分全在 SFT 和 RL:RL(激发推理)→ 用 RL 策略生成约 1M 条长 CoT → 从干净的预训练 checkpoint 重新 SFT → 再做一次针对奖励的 RL。
数据怎么做
预训练共约 625B token:通用 389B,具身加感知 236B。后者里空间和机器人数据占 43%,其余是视觉感知。
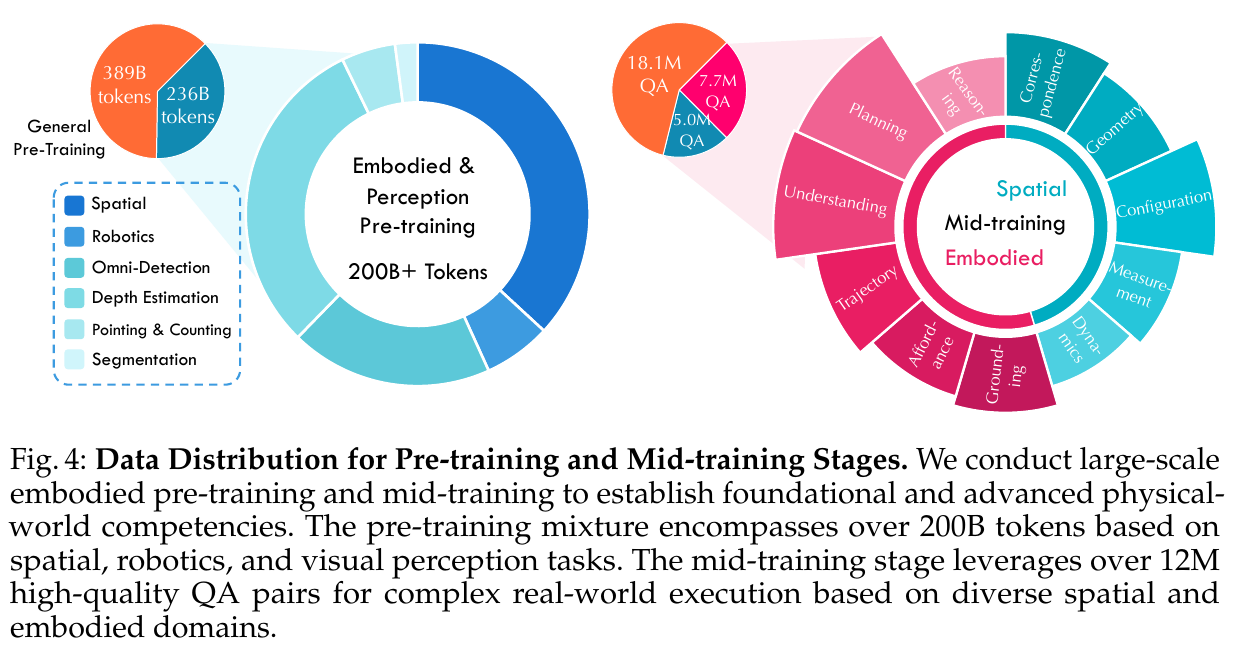
| 数据类型 | 规模 | 怎么造 |
|---|---|---|
| Omni-Detection(2D/3D 检测) | 62M | OpenImages、Objects365、RefCOCO、SA-1B。标注好的直接转换格式;没标或标得差的,先用 VLM 识别物体,再用 SAM + VLM grounding 定坐标,最后用更强的 VLM 校验。坐标统一归一化到 0–1000 整数 |
| 深度 | 约 36M | 用室内外 3D 数据集和自动驾驶传感器真值,在指定像素上问绝对 / 相对深度。采样点避开边界和无穷远,焦距统一归一化 |
| 分割 | 约 5M | SA-1B 掩码过滤后,按 PaliGemma 的方式扩展词表,让模型直接输出掩码 |
| 点选与计数 | 约 11M | Pixmo-Points 等,特意挑选目标密集的场景 |
| 具身:grounding / 可供性 / 轨迹 / 理解 / 规划 / 推理 | 中期训练共约 12M QA | 开源数据(Molmo、RoboPoint、RefSpatial、RoboAfford、ShareRobot、MolmoAct、RoboVQA 等)加自动标注。 轨迹 :用 CoTracker3 追踪 Open-X / DROID 视频里的机械臂,降采样到 ≤ 15 个路点画在首帧上,再用强 VLM 判对错。 规划 :用 VLM 标任务,按时间切分视频得到"下一步动作"真值。 可供性 :把已有 grounding 标注交给 VLM,反向生成对应的用户指令 |
| 空间:对应 / 几何 / 构型 / 度量 / 动态 | 同上 | 从 ScanNet、ScanNet++、ARKitScenes 和自采的带位姿 RGB-D 序列里用规则生成。例如物体尺寸取 3D 框最长边;距离取两个 3D 框的最小距离;距离 < 0.2 m 或深度差 < 0.3 m 的模糊样本丢掉 |
1.0 版在 SFT / RL 里又补了一批按"状态理解 → 动作转移 → 序列与纠错"组织的数据:
深度推理:激光雷达点投影到图像上,每张图最多保留 100 个候选点;焦距归一到 1000 px;用红箭头加绿点标出目标点,再合成 CoT。
社交交互:第一人称视频人工标注交互对象、视线、指向、姿态和情绪,另加 AVA、HICO-DET。
因果推理:把 Ego4D 等视频拆成带前提和效果的步骤,每步对齐到视频区间,再转成可执行性 / 效果预测类 QA。
失败感知:用机器人失败视频和被扰动的计划,让模型判断哪里出错、怎么恢复。
VLN:在 Habitat R2R-CE 里,先用最短路径 oracle 出演示,再用 DAgger 补模型自己走偏后的状态。
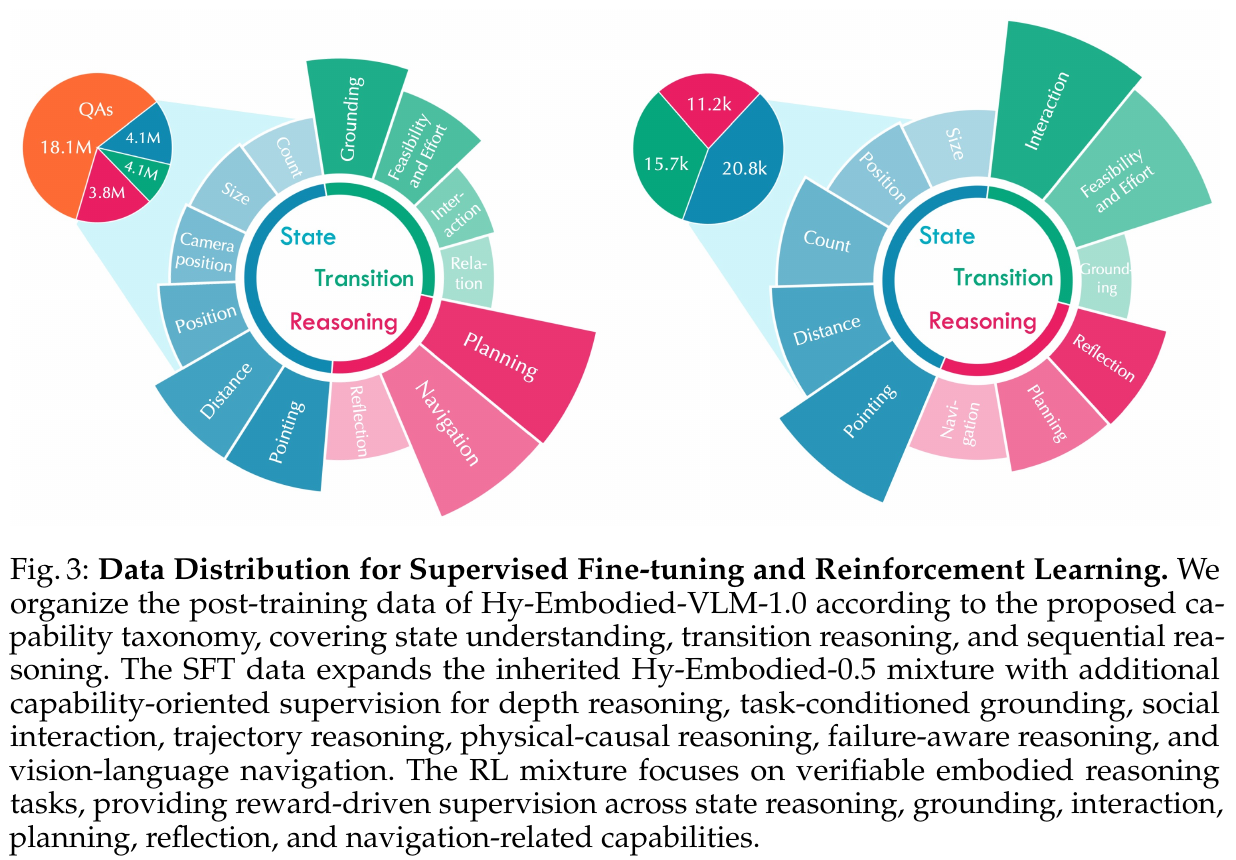
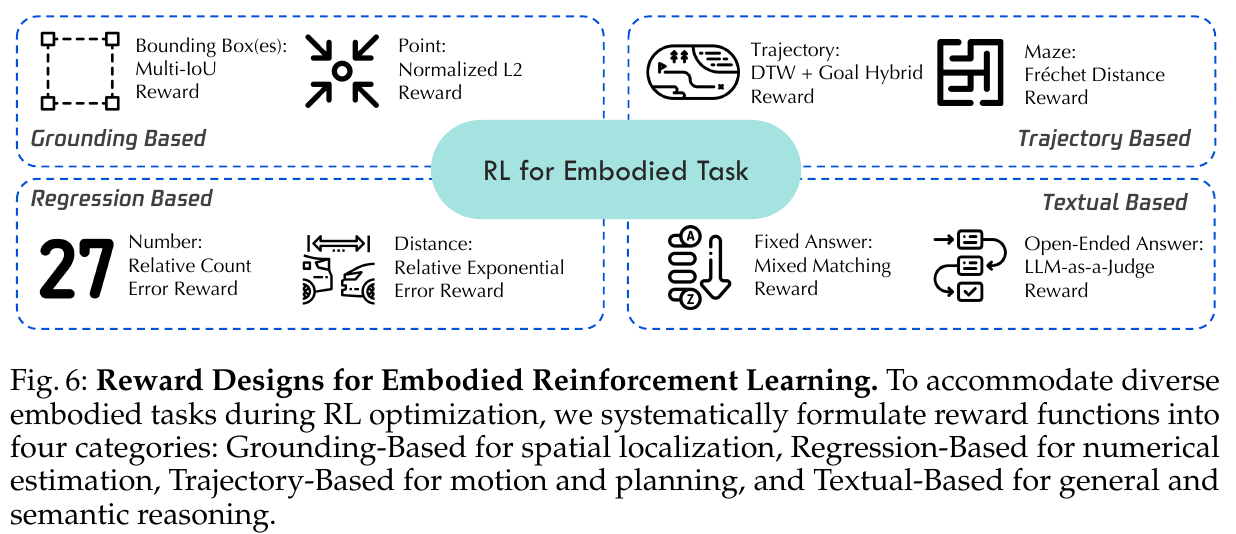
RL 数据和奖励:RL 数据不是固定的。每轮用当前模型在候选池上多次采样,全对的太简单、全错的太难,都丢掉,只保留部分做对的。再按感知 / 预测 / 交互 / 规划平衡,每轮 50K。奖励按输出的结构来定:
实验:0.5 版评了 22 个基准,MoT-2B 在其中 16 个上超过同尺寸模型,A32B 自称接近 Gemini 3.0 Pro。另在 Xtrainer 双臂上接了 VLA。1.0 版评了 38 个基准,在其中 19 个上是同尺寸最佳,平均比 0.5 MoT-2B 高 8.4%,并在 R2R-CE 的纯 RGB 设定下拿到 SOTA。
权重与部署。 能。HY-Embodied-0.5 放出了 MoT-2B(约 3.8B 总参,许可 other),32B 没放。Hy-Embodied-VLM-1.0 是 Apache-2.0,30.5B 总参,支持 transformers / vLLM。BF16 约 61 GB,5090 上需要量化(推断)。训练数据没有放出。
我的看法。 数据工程最系统,可以照着做的有三点:感知数据前置到预训练;用一套能力分类去配比数据;用"只留半对样本"动态构造 RL 数据。大部分数据是开源数据加 VLM 自动标注再由强 VLM 校验,人工标注只用在社交和少量 CoT 上。
RynnBrain:空间要落到视频和坐标里
在 Qwen-VL 上做"时空 + 物理落地"的具身预训练。图像中的空间输出(框、点、轨迹、抓取)都编码成 0–1000 的整数 token,并且输出里带关键帧编号,让模型在视频里定位"哪一帧的哪个位置"。两代:RynnBrain 1.0(2026-02,2B / 8B / 30B-A3B,基于 Qwen3-VL)和 RynnBrain 1.1(2026-07,2B / 9B / 122B-A10B,基于 Qwen3.5)。
模型和训练
结构就是 Qwen3-VL / Qwen3.5,没有改架构,全靠数据。工程上只加了按序列长度做的在线负载均衡。
1.0 版在基座上预训练后派生出四个变体:CoP(Chain-of-Point,推理过程中穿插坐标)、Nav、Plan、VLA。
1.1 版新增接触点预测和原生 3D 框(3D 只在 2B / 9B 上)。VLA 用 81 维统一动作空间加本体掩码,已部署在 Unitree G1、Astribot S1、**天机臂 + 无界灵巧手(Tianji-Wuji)**上。论文致谢里特意提到了 WUJI TECH 的硬件支持。
数据怎么做
1.0 版预训练数据共 19.89M 样本,分四大类:通用(4.8M)、认知(约 7.7M)、定位(约 7.3M)、规划(0.16M)。带"RynnBrain-“前缀的都是自建数据。
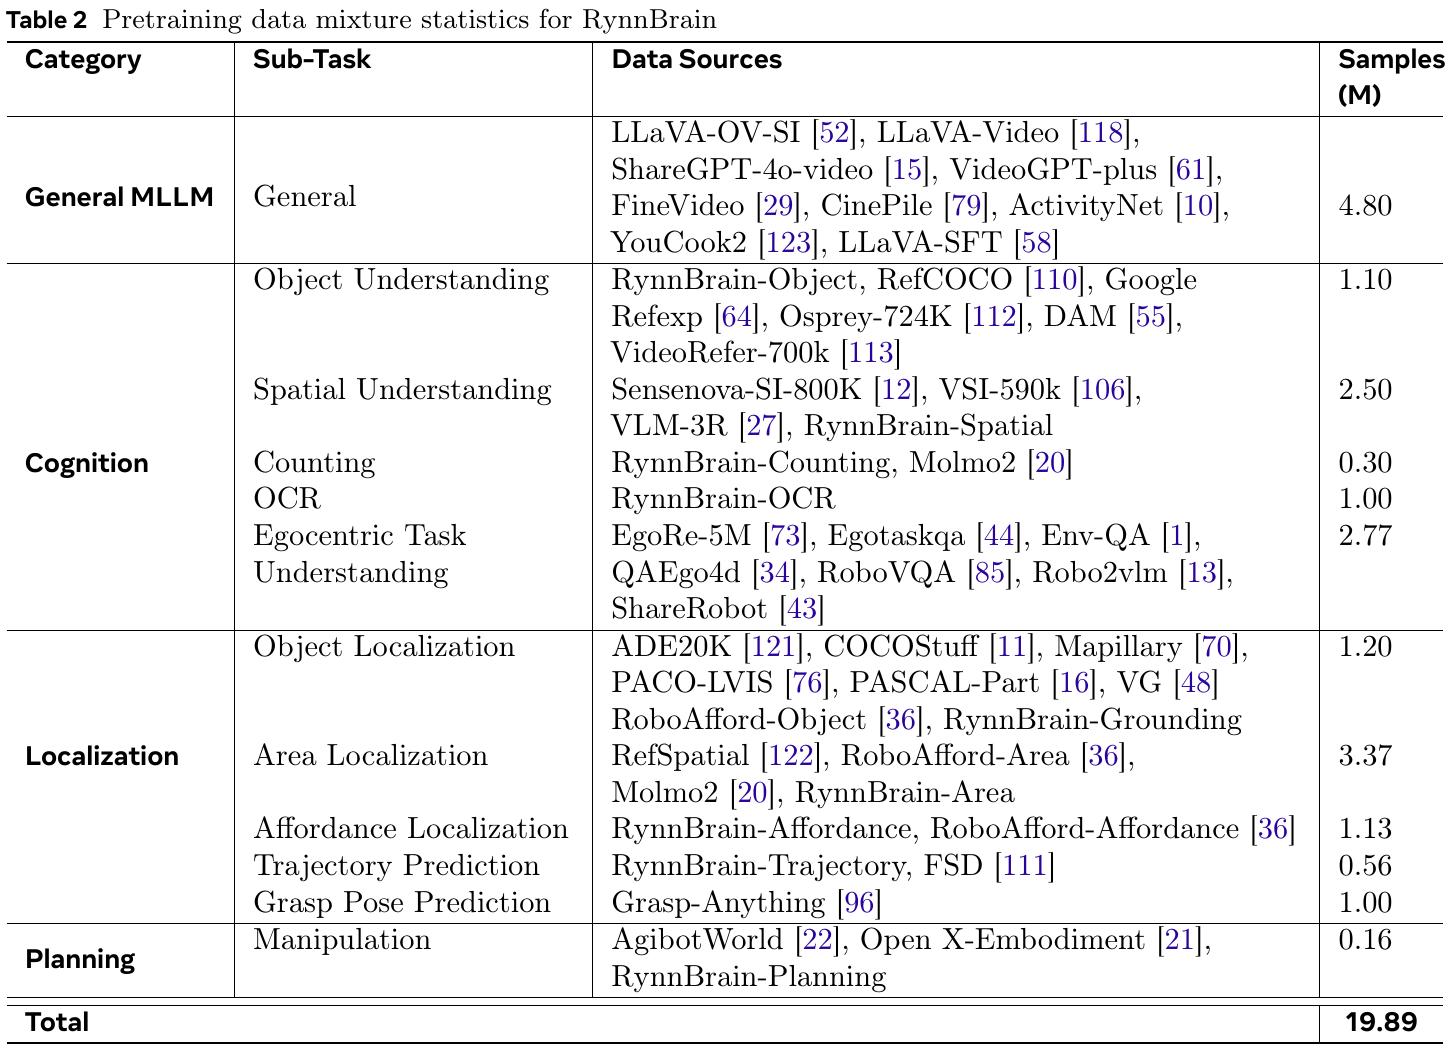
自建数据的流水线值得细看,核心是"自采的第一人称室内视频 + 开源工具链 + 人工过滤”:
物体理解:Qwen2.5-VL 识别物体 → Grounding DINO 1.5 在关键帧检测 → SAM2 分割并跟踪 → Qwen2.5-VL 生成 QA → 人工过滤,得到 712K。每个视频里同类物体最多保留 2 个实例。
空间理解:用 MASt3R-SLAM 从 RGB 视频重建点云和相机位姿,把实例分割投到 3D,用 RANSAC 找地面来对齐重力方向,再按模板生成距离、高度、方位 QA。得到视频 855K + 图像 272K。
OCR:在 Ego4D / EPIC-KITCHENS 里用 GoMatching 找出含字的 85K 个片段。人工标首次出现帧、最清晰帧、文字内容和多边形,再用 GPT-5.2 和模板生成约 1M QA。
区域 / 可供性 / 轨迹:视频部分各只有约 6K,由 LLM 生成指令、人工点选或画轨迹;图像部分各 45–51 万,用类似流水线生成。轨迹最多 10 个点。
抓取:Grasp-Anything 的旋转矩形转成 4 个角点,配 40% 物体导向 / 30% 场景导向 / 30% 任务导向的模板指令,共 1.3M。
规划:按 Hi Robot 的做法把长任务拆成原子动作(内部模型拆、人工核),每个子任务都标上目标物体框、放置区域点和可供性点。所以计划本身就是"文字 + 坐标"混合的。
CoP 推理数据:Qwen3-VL-235B 先写推理链,用方括号标出实体;内部模型判断每个实体是"区域"还是"物体";人工选最清楚的帧,打点或画框,再把坐标写回推理链。
RL 数据:用 SFT 模型给候选样本打分,只留 40–80 分的中等难度样本,再加一些关键帧选错的失败样本,共 30K。奖励用 Fréchet 距离(轨迹)、双向 Chamfer(可供性)、点是否落在多边形内(区域)。
1.1 版的数据更新在下表里用蓝字标出:
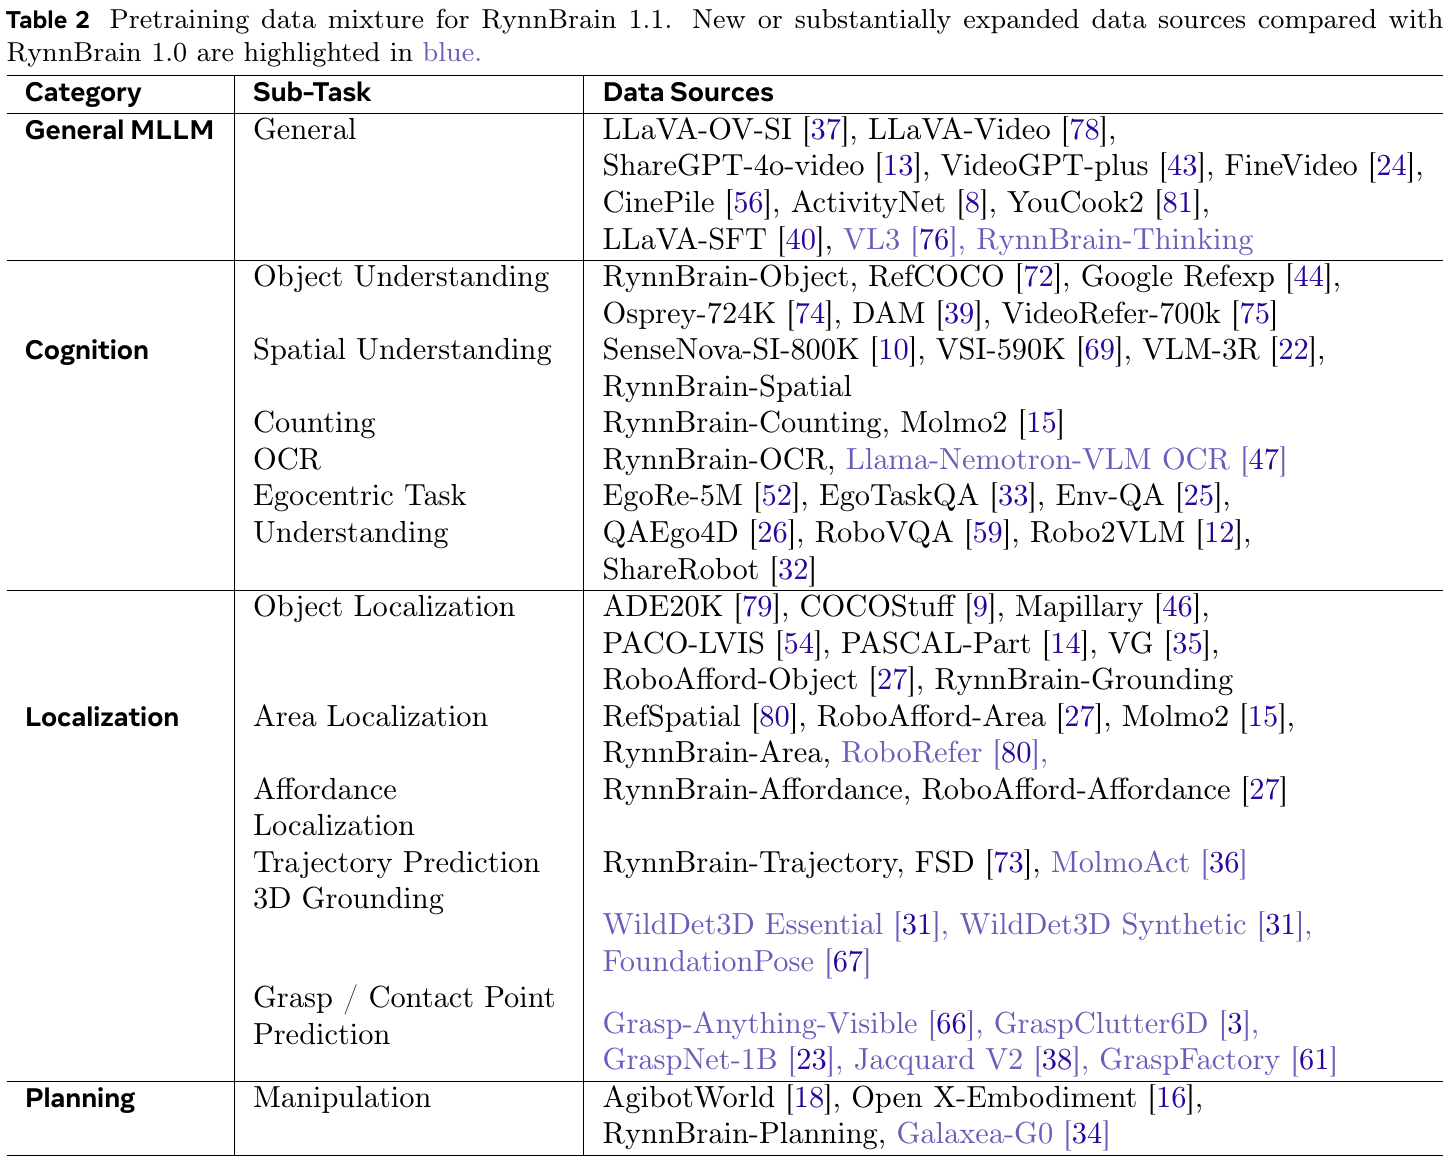
3D 框:WildDet3D(把 COCO / LVIS / Objects365 的 2D 框提升到 3D,Essential 子集 374K 人工校验 + Synthetic 子集 888K),加上 FoundationPose 合成数据(1,849K 张无噪声 3D 框,充当度量尺度的正则)。指代表达由 Qwen-VL 生成。
接触点:把抓取从"4 角点矩形"改成"中心点 + 夹爪角度",理由是矩形大小取决于夹爪和标注习惯,IoU 和执行成功率并不相关。从 GraspNet-1B 等仿真抓取数据里挑选可观测的相机视角渲染、投影,得到 2.6M。
规划:新增 Galaxea-G0,用 Gemini 3.1 Pro 从子任务标签反推高层任务描述。
实验:1.0 版在 20 个具身基准和 8 个通用基准上大幅领先已有具身模型;Nav 变体在 R2R / RxR 上是 SOTA;VLA 变体在复杂抓取上超过 π0.5 微调。作者还自建了 RynnBrain-Bench。1.1 版的 122B-A10B 在 VSI-Bench、MMSI、RefSpatial-Bench 上超过所有被测的闭源和开源模型。另有一个有意思的发现:在时空点选任务上,Qwen3.5 最大的模型也不如 RynnBrain 1.1 最小的模型,说明这类能力主要靠数据,而不是靠模型规模。
权重与部署。 代码、权重和 benchmark 均已发布,权重均为 Apache-2.0:RynnBrain-8B、RynnBrain1.1-9B、RynnBrain1.1-122B-A10B。9B 的 BF16 权重约 18 GB;单张 5090 是否够用,还要计入 KV cache 和视觉输入。自建数据是否公开,论文没有写清楚,需要去 repo 核实。
我的看法。 配方最朴素,不改架构,只靠数据覆盖度和统一的坐标输出。我最想借鉴的有三点:自采第一人称视频 + SLAM 重建 + 模板 QA 这套空间数据流水线;“计划里带坐标"的规划数据格式;以及 1.1 版已经跑在无界灵巧手上。
RoboBrain:3D 轨迹与任务进度
在 Qwen3-VL 上做两阶段具身训练。最新的 2.5 版主打两个新能力:一是单目 RGB 上的度量 3D 推理(输出带绝对深度的 3D 轨迹),二是稠密的任务进度 / 价值估计(可以直接当 RL 的奖励)。主要参考 RoboBrain 2.5(2026-01),上一代是 RoboBrain 2.0(7B / 32B)。
模型和训练
底座 Qwen3-VL-8B,全参训练两阶段:第一阶段"基础时空学习"8.3M 样本(通用语义、2D grounding、开环规划),第二阶段"专项增强"4.1M 样本(度量 3D 推理 + 稠密价值估计)。同一套配置同时在 NVIDIA 和摩尔线程 GPU 上训练。
3D 轨迹的表示:不直接预测相机坐标系下的 (x, y, z),而是预测 (u, v, d),即图像坐标加绝对深度,有内参就能投到 3D。好处是去掉 d 就是 2D 轨迹,只留起止点就是指代,所以现有 2D 数据都能混着训。
进度估计的表示:不直接回归"进度差”,而是预测两帧之间的"hop"——向前时用剩余距离归一化,倒退时用已走距离归一化,这样累积起来一定落在 [0, 1] 内。推理时把增量、以起点为锚、以终点为锚三种估计融合;后两者不一致时视为出分布,保守更新,防止 RL 刷分。
数据怎么做
共约 12.4M 样本,分通用、空间、时序三大域。右图是对数坐标,最大的三块是稠密价值估计、高质量通用数据和 3D 空间推理。
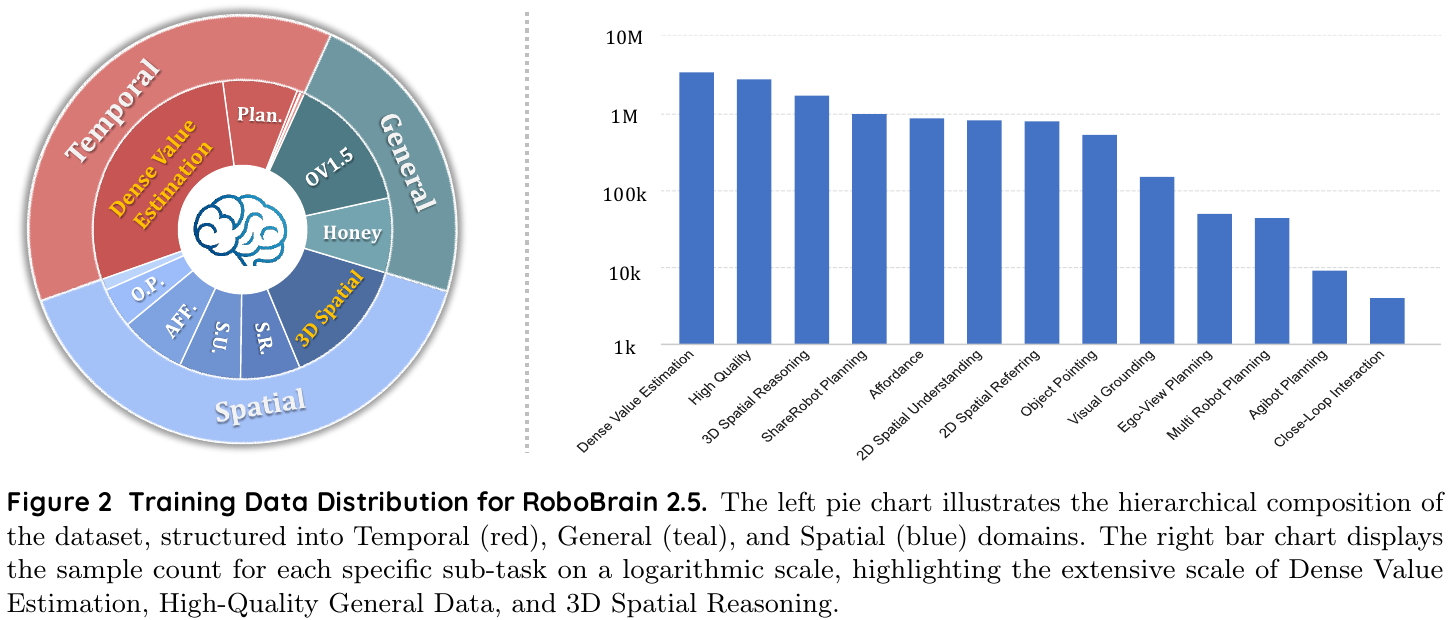
| 数据 | 规模 | 怎么造 |
|---|---|---|
| 通用 | 2.83M | Honey-Data-1M(去掉长 CoT,只留答案)+ LLaVA-OneVision-1.5(去纯文本、均衡采样),再去重 |
| grounding / 点选 / 可供性 | 86K 对话、190K、561K + 320K | LVIS 框转多轮对话;Pixmo-Points 去掉 >10 个点的样本,用 GPT-4o 只保留室内物体,配 28 个模板;PACO-LVIS 部件框加 GPT-4o 问功能(例如"手提包哪里可以握");RoboPoint 放置区域 |
| 空间理解 | 826K | 沿用 RefSpatial 流水线。OpenImages 从 1.7M 筛到 466K → RAM 打标签 + GroundingDINO 画框 → Qwen2.5-VL 生成从粗到细的描述(“左数第三个杯子”)→ UniDepth V2 + WildCamera 估深度和内参 → SAM 2.1 掩码 → 伪 3D 场景图 → 模板和 QwQ 生成 QA。另加 ScanQA / SQA3D 等扫描数据,以及 CA-1M(从 2M 帧筛到 100K) |
| 空间指代 | 802K | 从场景图里采"描述-点"对;放置类用 3D 数据生成俯视占用图,造"椅子右边 10 cm"这种度量指令 |
| 3D 度量推理(新) | 1.74M 样本 / 8.08M QA | 沿用 TraceSpatial 流水线:CA-1M、ScanNet 造带度量的物体轨迹;真实操作视频(AgiBot-Beta 从 167K 洗到 59K,DROID 从 116K 洗到 24K)加仿真 RoboTwin 2.0,用 Qwen3-VL 拆子目标,得到单 / 双臂的多步 3D 轨迹 |
| 规划 | 1M + 9K + 50K + 44K | ShareRobot(人工标注,12 种本体)、AgiBot Planning、EgoPlan-IT、用 DeepSeek-V3 合成的多机器人协作规划(1,659 种任务) |
| 闭环交互 | — | AI2-THOR 里合成"观察-思考-动作"轨迹,由 GPT-4o 补写思考过程 |
| 稠密价值估计(新) | 约 35M,降采样到 3.5M | 沿用 Dopamine-Reward 流水线,来自 27M+ 原始帧。真机约 60%(AgiBot-World、DROID、RoboBrain-X),仿真约 13%(LIBERO、RoboCasa、RoboTwin),人类视频约 26%(EgoDex)。人工标多视角关键帧把专家轨迹切成子任务,再在段内均匀采样,按 hop 分桶均衡,并加入一定比例的"零进度"样本 |
实验:3D 空间推理和价值估计两组基准上,和 Gemini-3-Pro、GPT-5.2、Mimo-Embodied-7B、RoboBrain 2.0 对比,自称领先。另有 TraceSpatial-Bench 和 RoboTwin 2.0 轨迹可视化,以及真机上受干扰时进度曲线会回落的演示。
权重与部署。 能。Hugging Face 上有 RoboBrain2.5-8B-NV、8B-MT(分别对应 NVIDIA 和摩尔线程训练)和 4B,均为 Apache-2.0;2.0 版有 32B。8B 的 BF16 权重约 16 GB;运行时还需要 KV cache 和视觉输入的显存。
我的看法。 最值得借鉴的是两个"表示设计":一是 (u, v, d) 让 2D 和 3D 数据可以混训;二是 hop 进度让一个 VLM 直接变成可用的稠密奖励模型。对灵巧手 RL 来说,第二点尤其相关。数据来源上基本是开源数据加自家的几条流水线(RefSpatial / TraceSpatial / Dopamine-Reward),重清洗、轻人工。
GroundingPI:先把位置找准
不做大而全的具身大脑,只做一个 4B 的"定位基座",把检测、指代、点选、OCR、GUI 等 11 种感知能力做到极致,再证明它当 VLA / 驾驶的视觉主干更好。arXiv:2609.39601,2026-09-30。作者列表里有 Siqiao Huang(清华)。
和 Astra 的关系:四家里只有它直接拿 GPT-6 Astra 当对手。在 34 个 grounding 基准上平均 73.68%,高于 Astra 的 71.54%。但这只是感知定位,不涉及规划和推理。
模型和训练
MoonViT-V2(Kimi K3 的视觉编码器)+ Qwen3-4B。1000 个量化坐标 token(
<0>–<999>)和类别名共用词表;查询的类别不存在时输出 None。流程:投影层对齐 → 通用多模态预训练 → 视频理解 → 8 类空间任务的坐标对齐 SFT → GRPO。总训练量 500.41B + 221.17B token,128 张 GPU。
RL 奖励:检测用 0.7 × 集合完整度(按 IoU 匹配每个参考)+ 0.3 × 严格定位(多阈值 F1,惩罚重复框和过大框);OCR 用 Hungarian 匹配同时评文字和位置。
数据怎么做
论文没有给出数据配比表,重点在"数据引擎"的机制(下图下半部分):
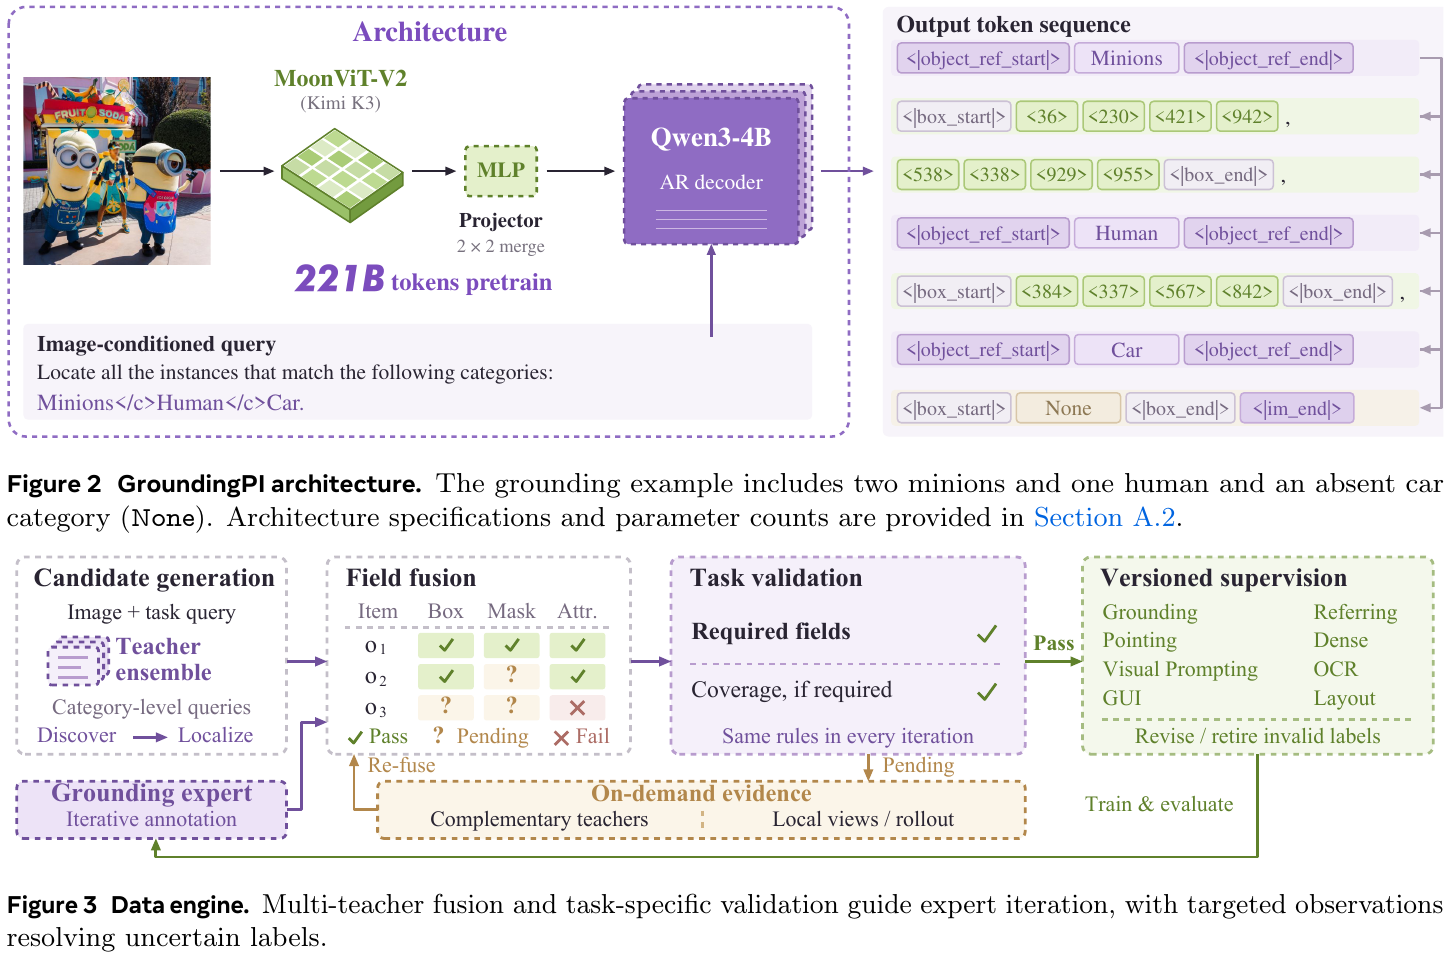
候选生成:多个互补的"教师模型"对同一张图、同一查询出标注;类别级查询先发现类别,再按类别定位。
按字段融合:类别、框、掩码、属性分开投票,每个字段标为通过 / 待定 / 失败。部件与整体、词与行的包含关系保留,不当重复合并。
按任务校验:只有查询要求的字段全部通过才接受;“找出所有实例"还要做覆盖度检查;“没有"也得被验证,空预测不算证据。
专家迭代:用已接受的标注训练一个统一的 grounding 专家,它的新预测再走同样的融合和校验。待定的字段会另外调用教师或裁剪局部视图来判定。标注可以被修订或撤回,并传播到依赖它的任务。
一份实例派生多任务:类别 + 框 → 检测;属性和关系 → 指代;实例区域 → 点选;示例对应 → 视觉提示;文字区域 + 转写 → OCR。
最有价值的实验是数据消融:把感知数据分成 6 组,逐组去掉,看下游操作和驾驶怎么变。
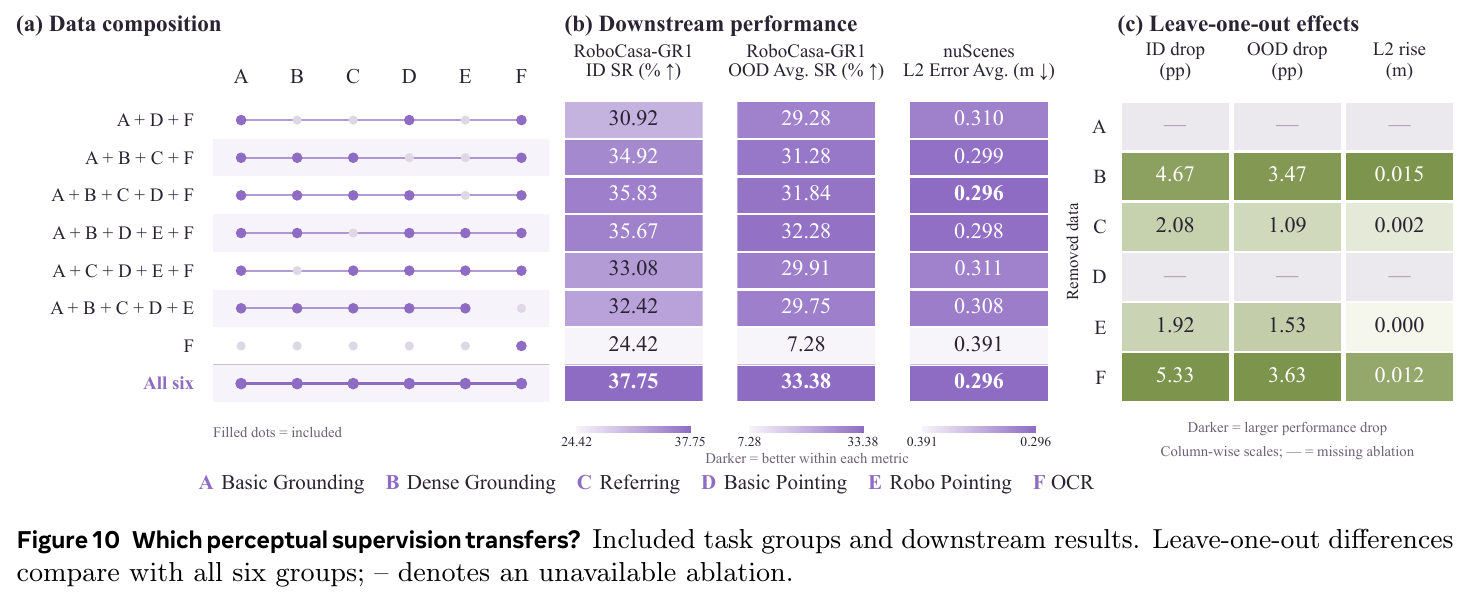
只用 F(OCR / 版面 / GUI)时,RoboCasa-GR1 OOD 成功率 7.28%;加上 A + D 后升到 29.28%。基础定位和点选对泛化最关键。
密集检测(B)去掉后下降最多(ID − 4.67 pp,OOD − 3.47 pp),是"空间核心”。
六组全用最好(ID 37.75% / OOD 33.38%)。OCR 单独没用,但和其他组配合时去掉它也会明显掉分(报告中的一项消融下降 5.33 个百分点)。
其他实验:同一个 Action DiT、同样的动作数据和预算下只换视觉主干,在 RoboTwin 2.0 的 4 个 OOD 设定上全部第一,最多相对次好的主干高 24.8%。在 RoboCasa-GR1 上,用 50% 演示数据就能超过其他主干用 75% 的结果。nuScenes 开环 L2 为 0.296 m(Qwen3-VL-4B 0.301,RynnBrain 0.308)。另有一个有意思的观察:RynnBrain 1.1 在 6 个操作设定上全部不如 1.0,作者怀疑是 Qwen3.5 的 Gated DeltaNet 结构不利于动作头取空间特征;这仍是解释性的猜测,不是已确立的因果结论。
权重与部署。 能。GroundingPI/GroundingPI 2026-10-14 上传,约 4.8B 参数,许可 other,适合先在单张 5090 上测试。另有 GroundAnything 系列仓库。
我的看法。 它给出了另一种思路:与其做全能大脑,不如先把"在哪里"做准,再让动作数据只管"怎么做”。数据引擎的"按字段融合 + 按任务校验 + 专家迭代"可以直接搬来做自动标注;消融结论(密集检测和点选最能迁移到动作)可以直接指导数据配比。
Embodied-R1.5:失败之后也要会做
天津大学和腾讯混元的 Embodied-R1.5 从早期的点选模型扩展到了空间推理、规划、纠错和轨迹。这里最值得看的,是怎么教模型处理一次没有成功的执行。只看成功演示,并不能学到抓空之后该怎么继续。
模型与接口。 开放的模型 基于 Qwen3-VL-8B-Instruct。框和点使用 0–1000 图像坐标,3D 轨迹额外输出以米为单位的深度,结构化答案放在 <answer>...</answer> 中。它另有接 flow-matching action expert 的 VLA 版本,所以看结果时要分清:输出空间目标和输出连续机器人动作,是两种实验。
新增数据花在哪里。 完整混合包含 34 个数据集,总量超过 15B token。三条自建流水线分别补不同的空白:
| 流水线 / 自建规模 | 怎么造 |
|---|---|
| 桌面空间 QA (约 20K) | 机器人场景图 → 语义标注、MoGe-2 几何和实例 mask → 对齐的 3D 场景图 → 几何问题 |
| 失败纠错 (约 800K) | 扰动计划;截断视频或替换执行描述;在仿真中注入失败。分别标检测、诊断和修复 |
| 功能点选与轨迹 (约 400K) | 仿真物体部件加已有可供性数据;投影末端位姿或跟踪夹爪 / 物体;补充关节物体轨迹 |
这些是自建子集的规模,不是整个训练集。SFT 数据和 RFT 数据分别发布,可以直接看两个阶段究竟给了什么监督。
SFT → 多任务 RL。 SFT 联合更新视觉编码器和语言模型,训练一个 epoch。RL 留下约 200K 中等难度问题,每题采八条 rollout,奖励完全相同的组不参与更新。优势用组内均值、整个 batch 的标准差:
分子比较同一道题的不同回答,分母改变各组之间的相对更新尺度。共同的分母并不自动保证每个任务贡献相同;任务采样和奖励定义仍然重要。
奖励按答案结构来:确定答案用 exact match,框用 IoU,点用距离,轨迹用误差,开放式规划 / 纠错用奖励模型。距离类奖励给部分分:
点集奖励的阈值是归一化坐标下的 40 和 150。3D 轨迹分别算图像平面与深度的得分,再等权平均;只输出一个点的“轨迹”直接记零。最后按 0.9 : 0.1 混合答案质量和格式分。这里 RFT 指 reinforcement fine-tuning,与 HY 的 rejection-sampling 缩写同名,但不是一回事。训练与奖励定义,§§4–5。
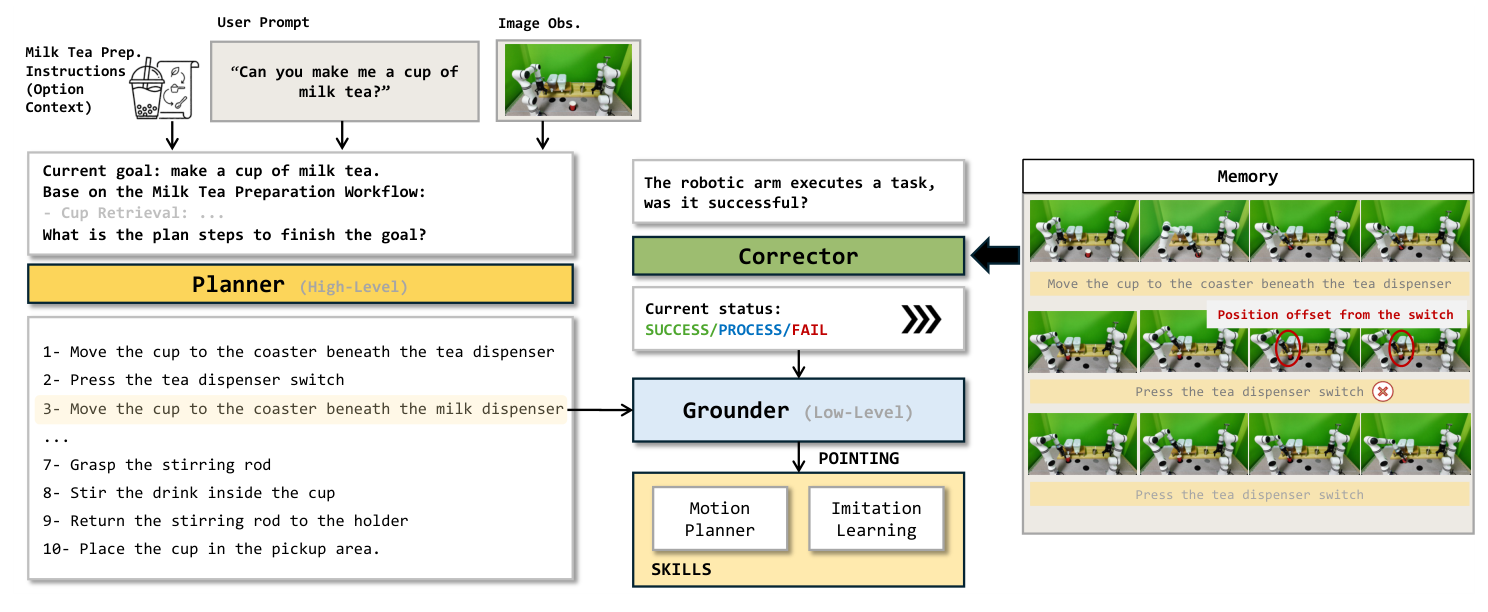
纠错怎么接回执行。 PGC 系统让同一个模型承担三个角色:Planner 选子任务,Grounder 给底层执行器提供目标,Corrector 判断成功、仍在执行还是失败。FIFO memory 保存最近的观察和状态;失败信息回到下一轮规划。它测到的能力比单次点选是否正确多了一层。
我会看什么。 把 RL 消融和闭环例子放在一起看:点选更准能提高第一次执行的成功率,纠错数据则影响失败后还有没有一次有效的重试。官方仓库链接了权重、两阶段数据和 EmbodiedEvalKit,因此这套配方可以具体检查,而不只看最终分数。
ACE-Brain-0.5:不同任务的输出别互相干扰
ACE-Brain-0.5处理的是把这些能力放进同一个模型后出现的问题:grounding 输出坐标,导航输出动作,进度估计输出时序分数。一个接口训得更好,可能把另一个接口训坏。
模型。 8B 底座沿用 ACE-Brain-0 和 Qwen3-VL 的基础,感知、规划与监控共享视觉语言上下文。操作走 flow-matching Action Expert,并用快速的 DINOv3 视觉通道接入最新观察。模型卡列出了开放权重和支持的接口。
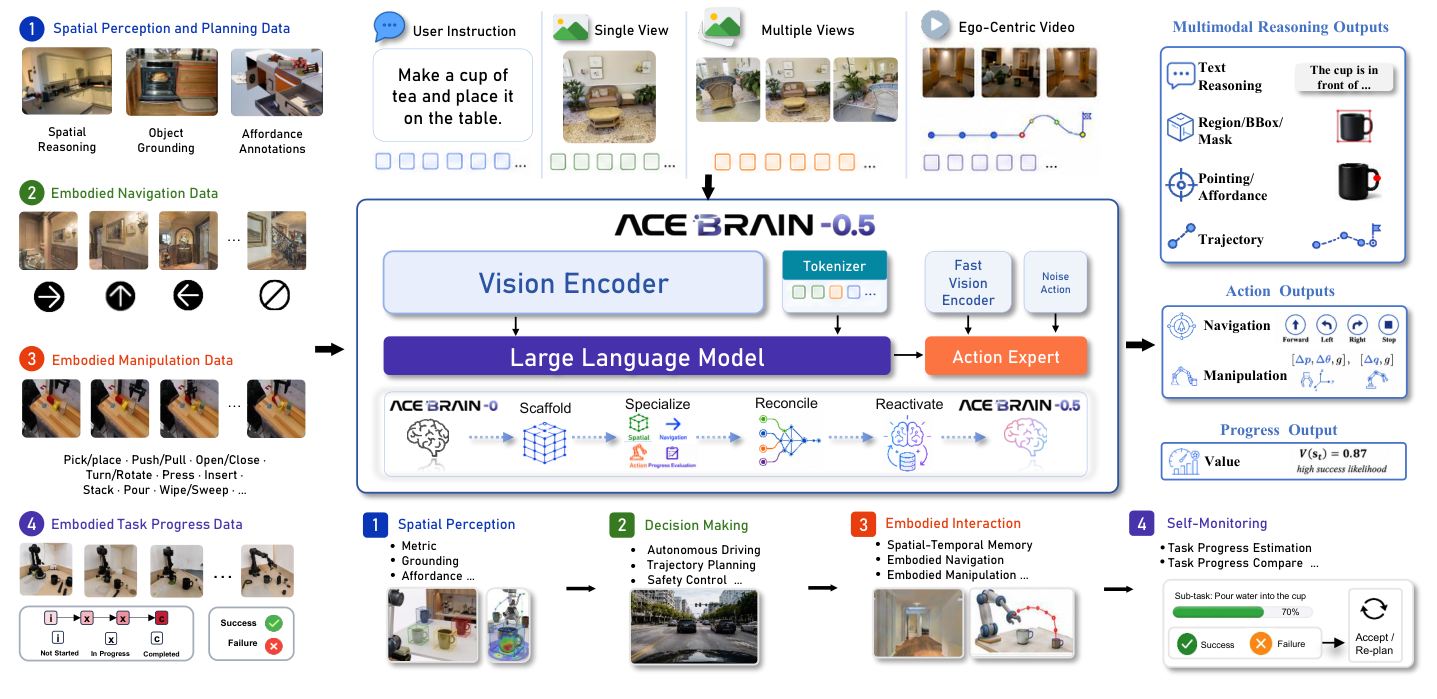
训练:SSR+。 四个阶段把“分别学会”和“放在一起还能用”拆开:
- Scaffold: 保留 ACE-Brain-0 提供的空间能力。
- Specialize: 分别训练 QA / 规划、grounding、导航、进度估计的专用 checkpoint。
- Reconcile: 将它们的参数更新与空间底座合并。
- Reactivate: 用少量混合 SFT 恢复一致的输出格式。
逐层合并的目标,是让合并后的层在各专家的输入上接近对应专家。用 W 表示该层权重:
实现中通过 FusionBench 做近似的、无数据 task-vector 优化,用 Adam 跑 1,000 次迭代,再进行 Reactivate。作者把快速恢复解释为:任务知识仍在,但输出格式需要重新校准。这是对实验现象的解释,不代表参数合并一定保留所有能力。SSR+,§3.2。
按接口组织数据。 大量监督仍来自公开数据:
| 接口 | 监督来源 |
|---|---|
| 空间推理 / grounding | VSI-590K、VLM-3R、GPT4Scene、MindCube;RefSpatial、PixMo-Points、RoboPoint。另用带几何校验的 Spatial Harness 造标注 |
| 导航 | R2R、RxR、EnvDrop、ScaleVLN 和 SRDF 派生指令,统一成“观察 / 历史 → 下一步动作” |
| 操作 | 机器人轨迹转成统一的状态 / 动作通道,缺失通道用 mask 标记 |
| 进度 | RBM-1M 转成 505K 多图样本:八帧进度序列,以及同任务轨迹偏好 |
进度训练时用 0–1000 整数,评测时再缩放。虽然数值范围和点选相同,表达的却是任务完成度。官方仓库提供模型入口,数据构造见 §5.1。
“自我改进”具体是什么。 报告里有两种机制。部署时可以更新外部任务模板、空间记忆和失败恢复案例,不改权重;导航实验则让当前策略 rollout,由 oracle 从偏离状态接管恢复,过滤这些轨迹后加入纠错训练。外部记忆更新和监督策略改进,不能算成同一个训练步骤。
值得保留的评测。 把成功轨迹倒放,物体和视频帧都没变,但动作是在撤销任务。ACE-Brain 用这种负例构造更严格的进度评测。对奖励模型来说,这个区别很实际:看到“接近完成”的画面,还不足以判断机器人正在取得进展。这里也适合与 RoboBrain 的 hop 进度表示对照。
Molmo 2-ER:先训具身底座,再接动作学习
Ai2 与合作者在 Molmo 2 上训练 Molmo 2-ER,再用它初始化 MolmoAct 2。配方比较直接:整理公开空间与视频数据,做具身专项训练,混回通用数据,最后才加入动作学习。
模型与训练。
- Qwen3-4B 语言底座加 SigLIP2 视觉编码器。ER checkpoint 输出文字和位置,后续 MolmoAct 2 checkpoint 才加入机器人动作。
- 具身专项训练: 约 3.3M ER 样本加 8% Tulu-3 文本,训练 20K steps。序列长度 4,200,global batch size 64,使用 16 张 H100。
- 混合微调: 混回 Molmo 2 的通用多模态数据,再训 1.5K steps。为容纳长视频和多图样本,序列长度增至 16,384,单卡 batch size 从 4 降到 1。
- 论文 §2.2 保留 8% 文本,将其余部分等分,即 46% 具身 / 46% 通用 / 8% 文本;模型卡则写 50/42/8。两处的阶段安排相同,精确配比还要核对发布的配置。
数据怎么造。 ER 这一层主要做数据选择与转换。不同来源补充不同监督:仿真真值、真实场景重建、人工标注视频和合成关系问题。
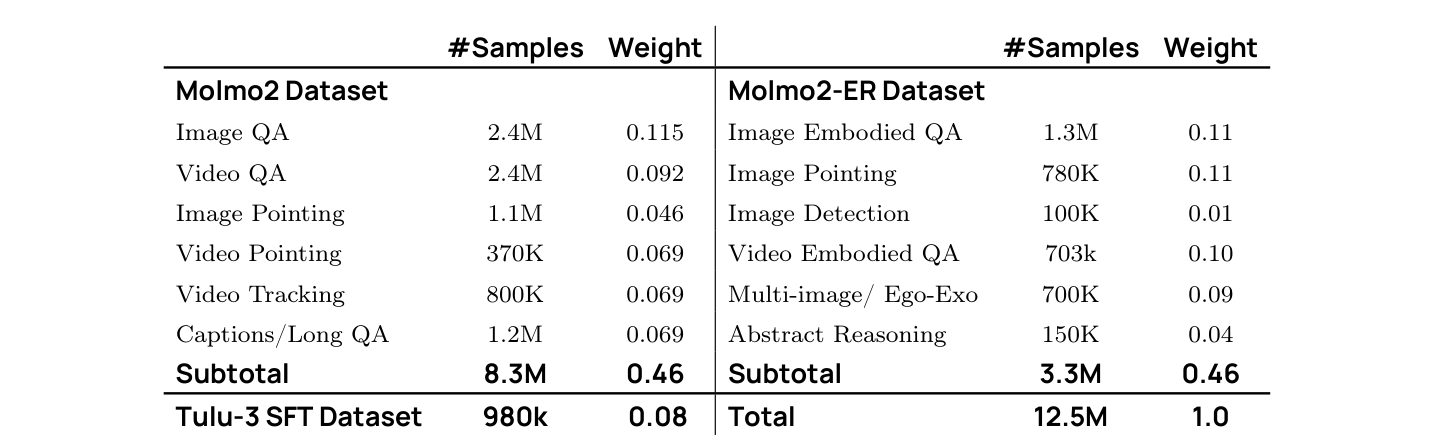
| 数据 | 构造与作用 |
|---|---|
| 单图空间 QA | SAT 提供仿真运动、视角变换和动作后果问题;RefSpatial 取 250K 选择题、250K CoT。VST-P 统一到虚拟相机,提供米制深度、距离、方向与尺寸;VSI-590K 从 3D 标注传播问题 |
| 点选与检测 | RoboPoint 的 700K 程序生成样本,用归一化 (x, y) 指定物体或空闲区域;再加 80K RefSpatial 点选和 100K LVIS 派生检测 |
| 视频 QA | SIMS-VSI 提供 203K 仿真标注问题;RoboVQA 取 200K 规划、可供性与预测样本;VSI-590K 提供 300K 视频样本 |
| 多图 / ego–exo | SenseNova-SI 取 500K,加 VST-P 的 200K 跨视角样本,学习不同相机与第一 / 第三人称之间的对应 |
| 抽象关系 | 50K CLEVR、100K GRiD-3D;后者专门区分物体自身的前 / 左,与相机视角的前 / 左 |
以上是论文报告的来源子集。Table 1 各类别数量的加总与所列 3.3M 小计并不完全一致,因此不把这些数字当成已经核实的互斥划分。
怎么接动作。 MolmoAct 2 先用 FAST 类 tokenizer 学离散动作 token,再在后训练中接入 flow-matching 动作专家。每一层把 VLM 的 key / value 经投影送入动作专家的 cross-attention,训练目标同时保留离散 next-token 监督与连续动作监督。
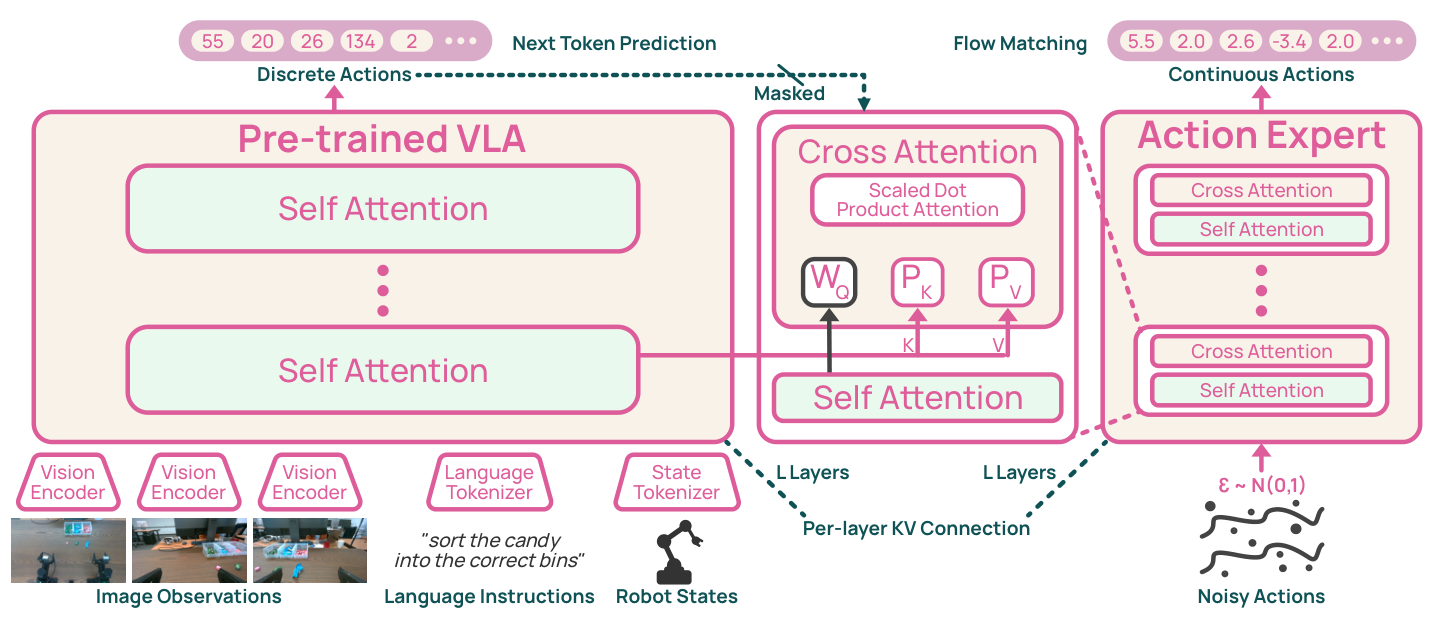
机器人数据包括 720 小时双臂 YAM 示范,以及过滤后的 DROID、SO-100/101。DROID 去掉 idle 片段,保留有语言标注的成功轨迹;SO-100/101 检查数据结构、排除评测类数据、检查使用资格,再按轨迹质量过滤。MolmoAct2-Think 进一步预测深度 token,并在相邻步骤复用没有变化的场景区域。
结果与消融。
- ER 在 13 个具身推理 benchmark 上平均 63.8%,比相同评测下的 Molmo 2 高 17 个百分点。
- 固定离散动作训练配置、训练 60K steps,只替换底座,LIBERO Long 从 77.6% 提到 83.6%。此时尚未接连续动作专家。
- 从 MolmoAct2-Pretrain 出发比较连接方式,四个 LIBERO suite 平均分:逐层 hidden state 94.0%,per-head KV 94.8%,投影后的逐层 KV 95.9%。
- 最终针对 benchmark 微调的策略,MolmoAct 2 达到 97.2%,Think 达到 98.1%。这里包含后续动作训练,不能全部算作 ER 底座的收益。
权重与部署。 Molmo 2-ER采用 Apache-2.0。仓库分别链接 ER、离散动作预训练、连续动作和 Think checkpoint,以及训练代码与数据。实际执行需要选择适配目标本体的动作模型。
我的看法。 两点容易借鉴:按空间能力组织公开数据,以及固定动作学习设置来检验具身底座。混回通用数据的阶段很短,可以作为一个单独调整的环节,不必为此重跑整套多模态预训练。
Gemini Robotics-ER:定位、监控与高层规划
Google DeepMind 的 Gemini Robotics 1.5 报告描述了两个模型:Robotics-ER 做具身推理与工具调用,Robotics 是输出动作的 VLA。两者组合成高层规划器和底层执行器。报告里具体展开的是输出能力与闭环评测。
模型与训练。
- ER 接收图像 / 视频和请求,输出 grounded answer、点、轨迹、状态估计或工具调用。VLA 还接收机器人状态,输出连续动作。
- ER 可以先生成不同长度的 thinking token 再回答。1.5 的实验里,图像 / 视频 QA 比点选更受益于增加 thinking budget。
- 报告没有公开 ER 的完整数据量、配比与训练日程;机器人示范和 motion transfer 部分描述的是 VLA。后来的 ER 1.6 模型卡说明底座为 Gemini 3.0 Flash,加入额外具身训练,但仍未给出可复现的数据配比。
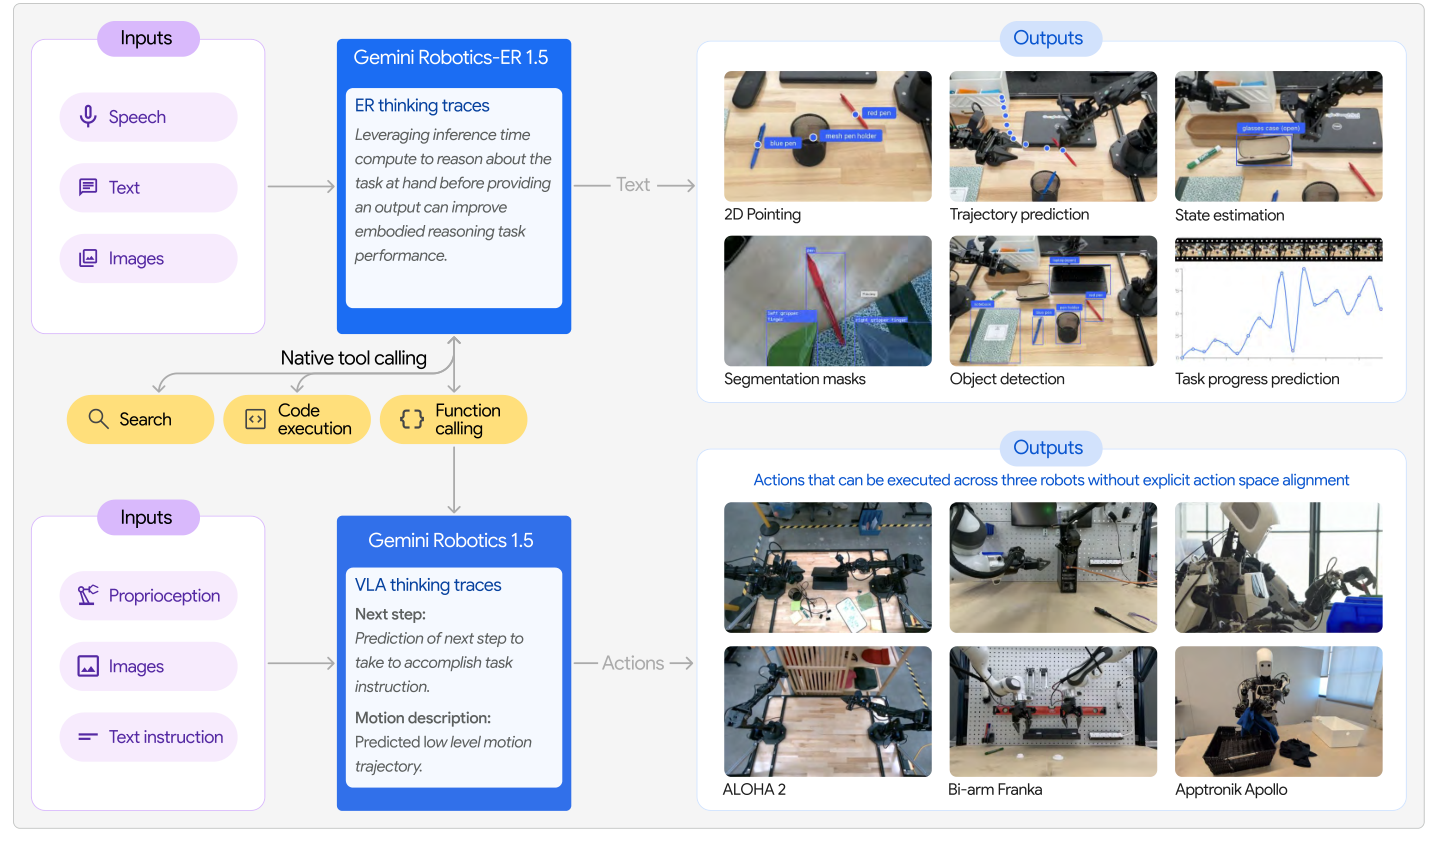
任务接口。 下表列的是演示或评测过的能力,不是已公开的训练数据清单。
| 任务 | 输入与输出 |
|---|---|
| 空间点选 | 图像 + 关系描述 → 目标点,也包括“杯子左边的空位”这类自由空间位置 |
| 可调整点选 | 图像 + 修正要求 → 新位置,例如把点稍微向上移动 |
| Point-to-count | 先用点标出实例,再返回数量 |
| 轨迹 | 连续多个点,表示满足空间或物理约束的路径 |
| 进度 / 成功判断 | 任务描述 + 单 / 多视角观察 → 完成度或成功判断 |
| 时序排序 | 打乱的任务帧 → 各帧完成度,据此恢复顺序 |
| 高层规划 | 任务、观察与历史 → 下一条指令或工具调用,执行后再检查 |
点选结果。 Fig. 10 汇总 Point-Bench、RefSpatial、RoboSpatial、Where2Place 和 PixMo Count。点落在目标 mask 内记为正确;计数任务检查最终数量。
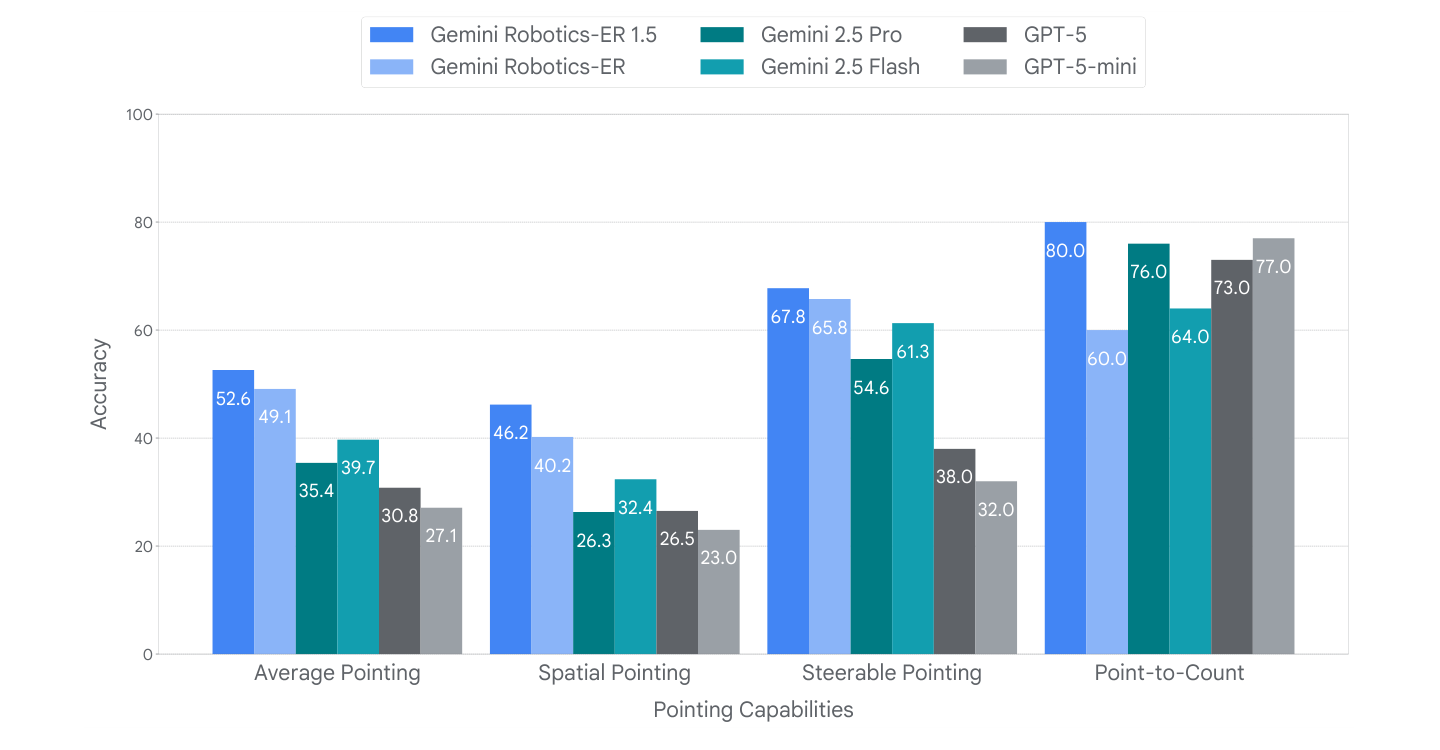
综合分从早期 ER 的 49.1% 提到 52.6%。空间点选上,ER 1.5 为 46.2%,同一评测下 Gemini 2.5 Pro 为 26.3%,GPT-5 为 26.5%。前面 RynnBrain 1.1 引用的 ER AP@15 48.3 则是 3D grounding,任务和指标均不同。
成功检测。 报告同时区分单 / 多视角与离线 / 实时评测。实时设置按 5 Hz 查询录制的 rollout,计入推理延迟,使用当前已返回的最新预测;离线设置给每次预测不限时的推理预算。
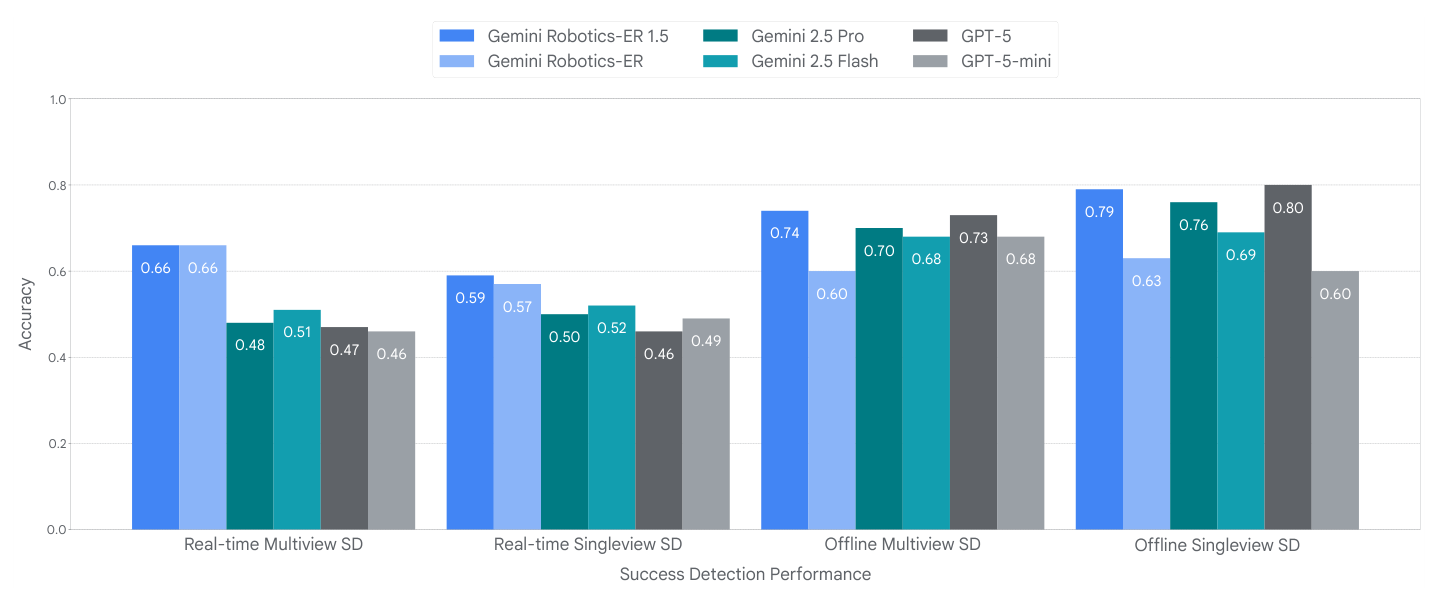
ER 1.5 在实时多 / 单视角上为 0.66 / 0.59,离线为 0.74 / 0.79。GPT-5 在离线单视角上达到 0.80,但实时单视角为 0.46。这说明 monitor 的评测应该计入延迟:答案本身正确,回来时机器人已经进入下一状态,也可能给控制提供错误信号。
闭环执行。 Agent 把带场景定位的子任务发给 Gemini Robotics 1.5,观察执行结果,再更新计划。ALOHA 与双臂 Franka 上的八个任务比较三种设置:单独的 thinking VLA、Gemini 2.5 Flash + VLA、ER 1.5 + 同一个 VLA。任务包括记住并恢复物体排列、借助搜索分类,以及九步抽屉任务;Franka 额外做了长任务后训练。Fig. 17 的收益随任务变化,例如 Desk Organization 的进度分从 Flash 的 0.56 提到 ER 的 0.88,而 Nut Allergy 两者均为 0.78。
开放情况与后续版本。 ER 是闭源模型,没有开放权重训练配方。ER 2 发布扩展了 Gemini Live API 下的流式交互和工具调用,并用五个完成度区间评测进度。本节原图均对应 ER 1.5,引用实验和后续接口时应保留版本号。
我的看法。 最值得复用的是评测设计:点能不能用、监控能不能及时返回、固定执行器后换高层有没有收益。这些测试也适用于前面的开源模型。
数据构建
先看与具身任务混合的通用多模态数据,再展开三种专项监督来源:从图像生成空间问题、让多视角共享几何,以及从执行视频生成时序问题。
LLaVA-OneVision:与具身任务混合的通用多模态数据
LLaVA-OneVision 开放的训练混合包含通用 VQA、OCR、文档理解和指令跟随,为具身训练补充更广的视觉语言监督。这里复用的是数据配方,不要求同时采用 LLaVA 模型。
具体是哪份数据。 初代 OneVision包括 3.2M 单图指令样本,以及后续 1.6M 单图、多图、视频混合样本。OneVision-1.5 报告开放了更大的两份数据:85M 中间训练图文对与 22M 指令样本。它们属于不同发布和训练阶段,只写“LLaVA-OV 数据”还不能确定用了哪个池子。
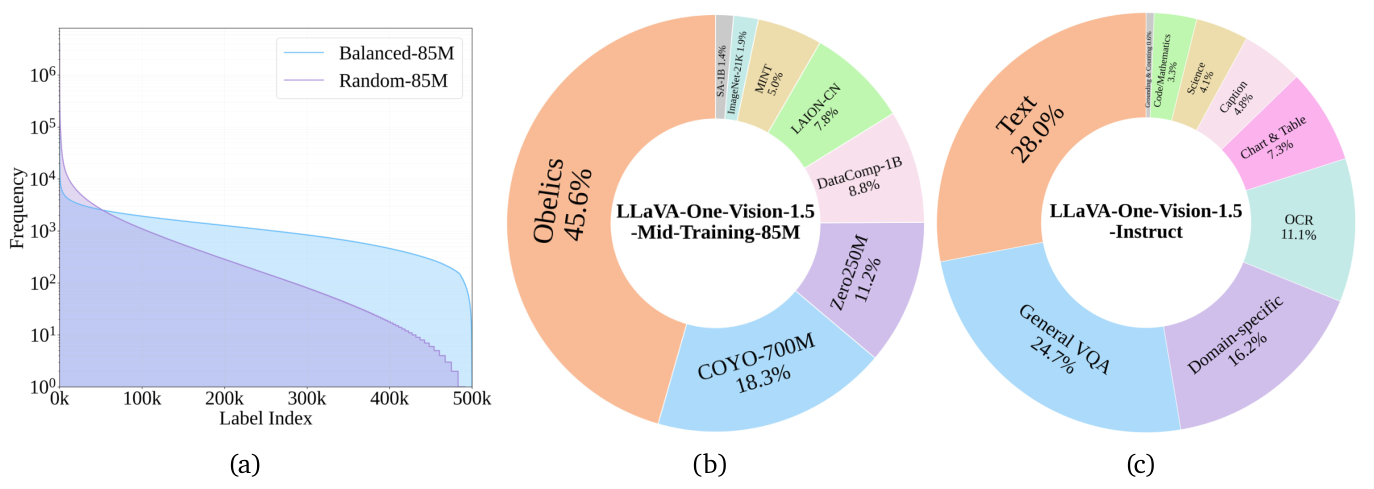
1.5 的数据怎么造。
- 按概念选图。 汇集 COYO、Obelics、DataComp、ImageNet、SAM 等来源。MetaCLIP 编码图像和 500K 概念词表,给每张图匹配相近概念,再按概念频率的倒数加权采样,降低常见概念的支配程度。
- 生成描述。 Captioner 生成中英文描述,再过滤重复、过长等无效输出。报告的 85M 数据包含 65M 英文、20M 中文图文对。
- 整理指令任务。 将已有数据集整理为 22M 指令池,覆盖描述、通用 VQA、OCR、图表、grounding / counting、科学、代码 / 数学与领域任务。
具身论文怎么用。 OpenSpatial将通用 OneVision 数据与空间推理数据按 1:1 混合,保留通用多模态能力。RoboBrain 2.5用的是 OneVision-1.5-Instruct:先去纯文本、平衡视觉子类,再与 Honey-Data-1M 按图像和 QA 相似度去重。最后的 2.83M 是合并后的通用子集,不是 OneVision 本身的规模。
可复用的是任务覆盖与过滤方法。通用数据占多少仍是训练选择:OpenSpatial 的 1:1 是明确报告的实例,并非本文所有模型共同采用的比例。
SpatialVLM:从图像几何生成空间 QA
SpatialVLM从 10M 真实图像生成 2B 空间 QA,定性关系与定量测量各占一半。流水线主要由预训练视觉模型和模板组成。
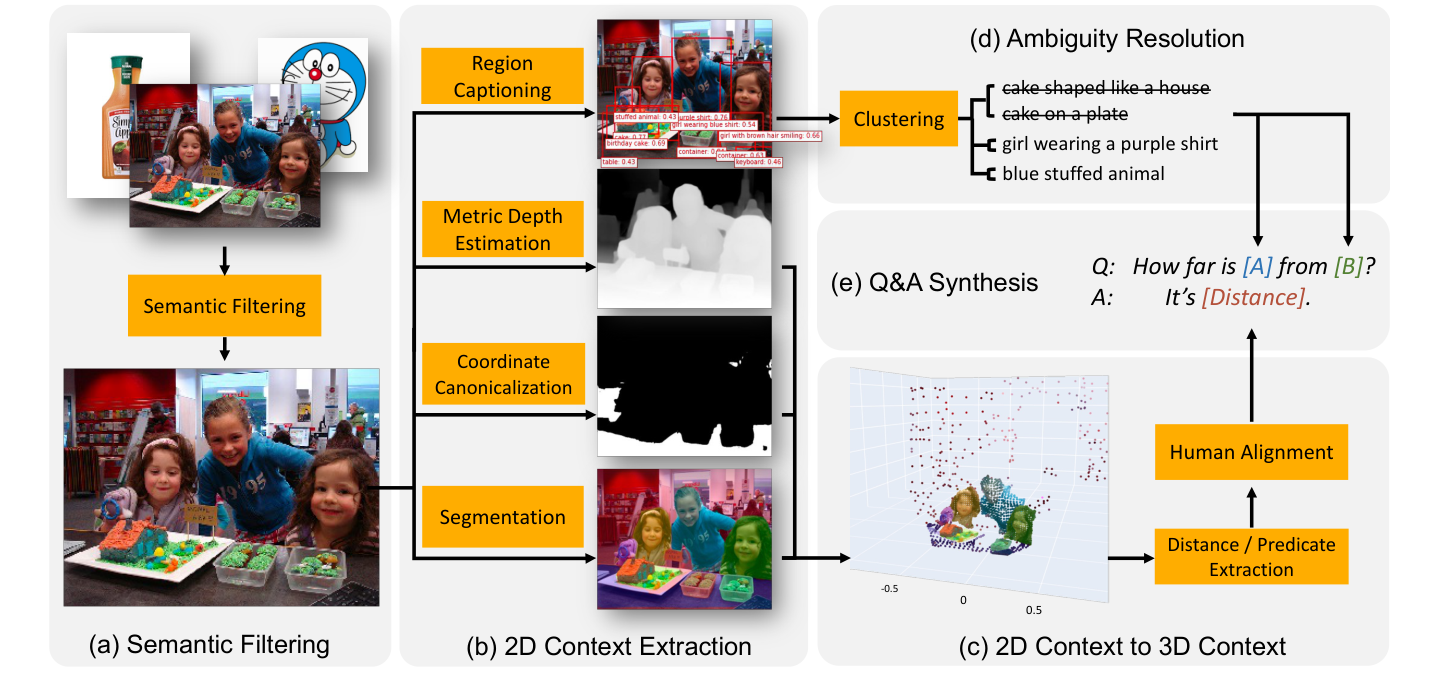
数据怎么造。
- 用 CLIP 排除不适合的图像,例如孤立商品图和屏幕截图。
- Region proposal、FlexCap 描述与分割提供物体级标注。细粒度描述把“房子形状的蛋糕”和另一个蛋糕区分开。
- 米制深度把像素提升到 3D,地板、桌面等水平面提供坐标对齐参考。
- 用描述相似度识别指代歧义,修改或丢弃;根据物体点云和框计算距离、尺寸与关系。
- 模板生成 38 类问题,每类约 20 个问题模板、10 个答案模板;数字带单位,并按自然表达取整。
训练与使用。 沿用 PaLM-E 架构,将语言底座换成 PaLM 2-S,混合训练中 5% token 来自空间任务。论文研究了视觉编码器微调,也用预测距离生成奖励。这已经是后来伪 3D 场景图配方的一个具体版本;米制标签的质量仍受深度估计误差影响。
OpenSpatial:让多个视角共享一个场景表示
OpenSpatial生成 3M 样本,覆盖五类任务、19 个子任务。中间表示是 Z-up 世界系里的有向 3D 框:中心、边长和旋转。相机移动后,物体身份保持一致。
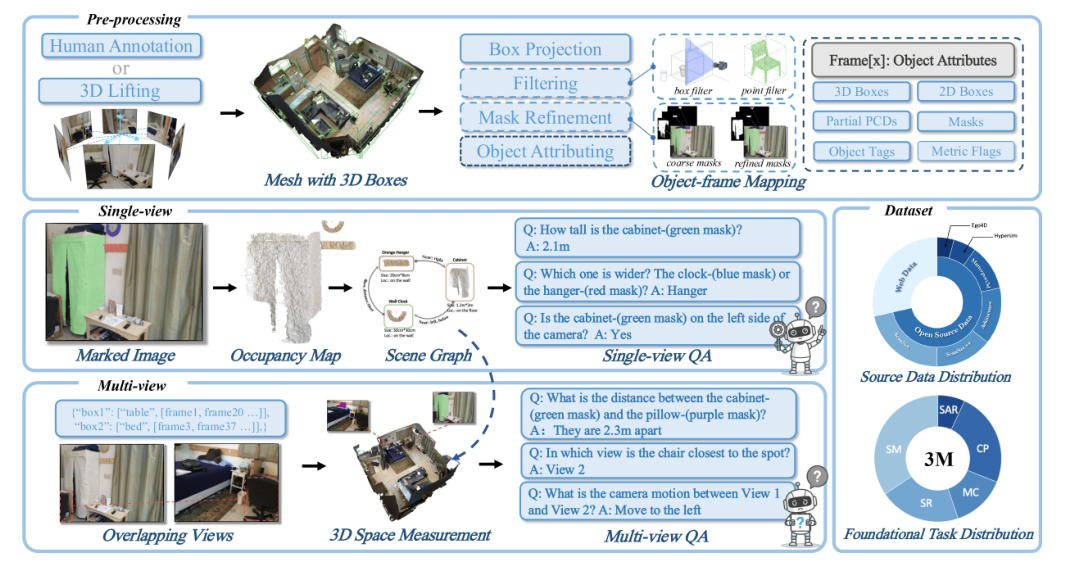
数据怎么造。
- 人工标注或自动 lifting 得到场景框。自动路线用 Gemini 识别物体、SAM 提取 mask,在 3D 中关联实例,再拟合有向框。
- 将框投影到各相机。剔除视锥外物体,再反投影深度像素,检查点云在 3D 框内的占据情况,过滤遮挡实例。
- 用 SAM 精修保留的 mask。物体—帧索引保存 mask、2D / 3D 框、局部点云、标签和 米制尺度标记。
- 从场景图生成单视角问题,从重叠视角生成多视角问题。米制标记为 false 时,跳过测量问题。
覆盖与开放。 五类任务是度量、空间关系、相机感知、多视角一致性和场景推理,数据引擎已开源。相比每张图独立造 QA,这个设计给跨视角问题提供了共同几何,也明确检查能不能生成米制答案。
RoboVQA:从执行视频生成时序 QA
RoboVQA在三栋办公楼采集 238 小时视频,包括机器人、人手和人使用抓取工具三种执行方式。数据包含 5,246 条长任务、92,948 个中等长度片段;开放版本列出 829,502 个视频—文本对、29,520 条不同指令。
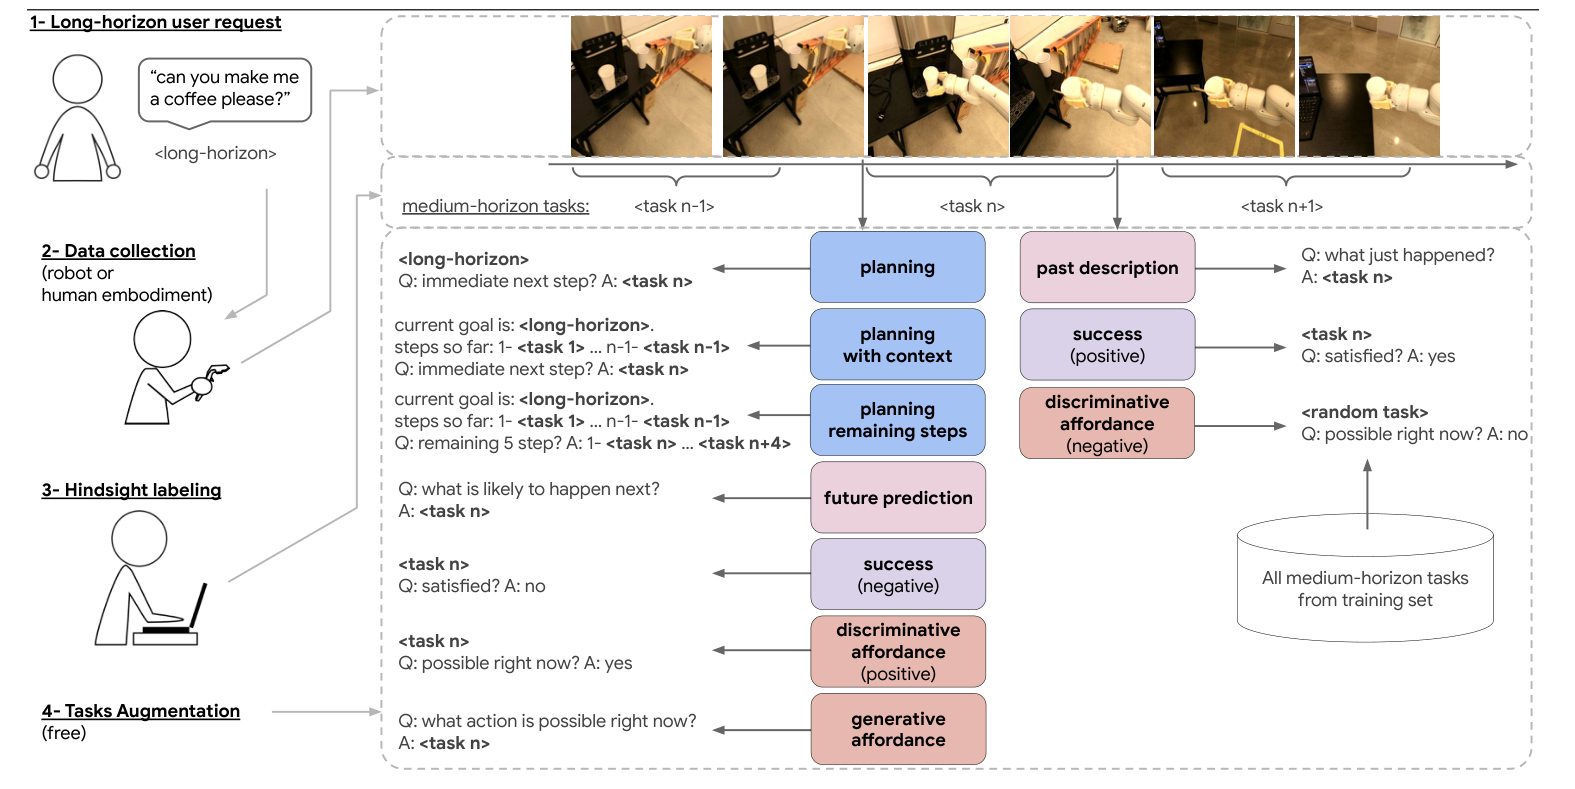
数据怎么造。 用户和操作者提出长任务,例如做咖啡;操作者连续完成,再由标注员切分片段、描述子任务。已知的顺序派生十类 QA:下一步规划、带历史规划、剩余步骤、未来预测、过去描述、成功 / 失败,以及生成式或正 / 负判别式可供性。例如片段边界前后的观察,就能用来问“任务完成了吗”,无需每个问题重新标注。
训练与结果。 RoboVQA-VideoCoCa 在这些数据上微调一个 383M 视频—文本模型。论文比较单帧与 16 帧输入,视频有明显收益;混合人与机器人数据,对纯机器人测试也有帮助。连续采集减少了场景重置,机器人采集吞吐达到逐步采集基线的 2.2 倍;事后切分仍需要人工成本。
评测分别覆盖录制视频、实时遥操作与自主执行。解释 intervention 减少时要保留这一区别:规划需要的纠正变少,仍可能同时由人控制全部物理动作。
闭源前沿与其他相关工作
公开论文里直接和 GPT-6 Astra 正面对比的很少。目前只有 GroundingPI 在感知定位上宣称超过它;其余多是拿 Gemini Robotics-ER 或 GPT-5.x 当标杆,或者是把 Astra 当测试对象的 benchmark。下表的 RobotWorld、PLAN-Bench 用作评测参考;Vlaser 保留为简短线索,MolmoAct 2 一行则记录另一项外部报道的执行测试。
| 工作 | 是什么 | 数据上的要点 |
|---|---|---|
| RobotWorld (2026-10,benchmark) | 让多模态 agent 通过工具调用操控多种机器人 | Astra 完成 84 个任务中的 16 个(19.0%),Opus 5.5 完成 13 个,Kimi K3 完成 2 个。Astra 在空间和受限接触类任务上更强。说明即使是 Astra,闭环执行也远没解决 |
| PLAN-Bench (2026-10,benchmark) | 699 题,测空间认知、时序推理和多步规划 | 28 个 VLM 里最高是 Qwen3.8-Max 75.0%,Kimi K3 70.2%,GPT-5.6-sol 65.8%。论文没有测 Astra |
| Vlaser (ICLR 2026) | VLM 到 VLA 的过渡模型 | 6M 样本的具身推理数据引擎 |
| MolmoAct2(Ai2) | 开源动作推理模型 | 据 the-decoder 报道,在 StationeryBench 双臂桌面任务上 Astra 完成 7/100、中位进度 46;MolmoAct2 完成 0/100、中位进度 12。这是二手报道 |
关于 Astra 本身:公开信息只有新闻和第三方 benchmark。报道引用的研究者猜测,它在 3D 任务上的提升来自大量 3D 数据(如 Blender 场景)训练,OpenAI 并未公布配方。
把数据配方放在一起看
四家的数据都是同一个模子:大量开源数据统一格式,加上自建的自动标注流水线,再用强模型校验,少量人工兑底。差别在于各家押注的能力不同。
| HY-Embodied | RynnBrain | RoboBrain 2.5 | GroundingPI | |
|---|---|---|---|---|
| 底座 | 自研 Hunyuan / Hy3(MoT-2B、A3B) | Qwen3-VL / Qwen3.5 | Qwen3-VL-8B | MoonViT-V2 + Qwen3-4B |
| 预训练规模 | 约 625B token(具身 + 感知 236B) | 19.89M 样本 | 12.4M 样本(8.3M + 4.1M) | 500B + 221B token |
| 押注的能力 | 感知前置 + 自进化推理 | 视频时空定位 + 带坐标的规划 | 度量 3D 轨迹 + 稠密进度估计 | 精确定位作为动作的感知接口 |
| 坐标格式 | 0–1000 整数 | 0–1000 整数 token + 关键帧编号 | 0–1000 归一化;3D 用 (u, v, d) | 1000 个专用坐标 token |
| 主要自建数据 | 检测 62M、深度 36M、CoTracker 轨迹、RGB-D 规则生成的空间 QA、社交交互人工标注 | 自采第一人称视频 → SLAM 空间 QA、OCR、区域 / 可供性 / 轨迹人工点选、带坐标的规划、仿真抓取投影 | RefSpatial / TraceSpatial 流水线(单目图 → 伪 3D 场景图)、Dopamine-Reward 进度数据 35M | 多教师融合的数据引擎,一份实例派生多任务 |
| 机器人数据来源 | Open-X、DROID 等视频跟踪和切分 | AgiBot、Open-X、Galaxea-G0 + 自采 | AgiBot、DROID、RoboTwin、LIBERO、EgoDex | 不用机器人数据预训练 |
| 人工标注用在哪 | CoT 协作、社交交互 | 过滤、点选、轨迹、规划校核、CoP 推理链打点 | 进度关键帧、ShareRobot 规划 | 基本不用 |
| RL 数据 | 每轮动态只留"半对"样本,50K | SFT 打分 40–80 的样本,30K | — | GRPO,奖励 = 集合完整度 + 严格定位 |
| 数据是否开源 | 否 | 未写明 | 部分(RefSpatial / TraceSpatial 等已单独开源) | 未写明 |
补充的几个模型,各自回答了更具体的问题:
| 模型 | 对这份配方对照的补充 |
|---|---|
| Embodied-R1.5 | 失败纠错数据,以及平衡各任务的强化微调 |
| ACE-Brain-0.5 | 分任务训练、参数合并,再用短混合阶段恢复输出格式 |
| Molmo 2-ER | 具身专项训练后混回通用数据,并用固定设置检查动作迁移 |
| Gemini Robotics-ER | 编排与监控的评测方式;公开细节还不足以重建训练配比 |
OneVision 提供通用多模态监督;SpatialVLM、OpenSpatial 和 RoboVQA 分别补充图像估计几何、跨视角一致的场景几何,以及带时序问题的执行视频。
我会从这些流水线里取出六步来组合;并不是每个模型都用了其中的每一步:
定能力分类:先写一套能力分类(感知 → 空间 → 可供性 / 轨迹 → 规划 / 纠错),按分类配比数据、选 benchmark。HY 1.0 和 ACE-Brain 都是这样做的。
统一输出格式:框、点、轨迹、抓取都归一化成 0–1000 整数,和文字一起自回归生成。视频里再加关键帧编号,3D 用 (u, v, d) 或相机系 3D 框。
开源数据打底:通用多模态数据(如前面的 OneVision 混合)用于保留通用能力。OpenSpatial 采用 1:1 通用 / 空间配比,具体比例应按各配方核对;具身开源数据(RoboPoint、RefSpatial、RoboAfford、ShareRobot、VSI-590K 等)转成统一格式。
从几何真值用规则生成:带位姿的 RGB-D / 点云(ScanNet、CA-1M、自采 + SLAM)→ 3D 框 / 场景图 → 模板 QA。度量类问题(尺寸、距离、方位)几乎都这样造,并丢弃模糊样本。
从机器人 / 第一人称视频自动挖:用 CoTracker 追踪末端得到轨迹,用 VLM 切分子任务得到规划,用人工关键帧得到进度,用研究者标的失败样本得到纠错。之后都要用强 VLM 判断对错并过滤。
推理数据和 RL:大模型写 CoT、人工或强模型校验,得到 10 万量级的冷启动数据;RL 优先用可验证的任务,按当前模型能力筛"中等难度"样本,奖励跟输出结构走(IoU / L2 / DTW / Fréchet)。最后用 RL 策略再合成长 CoT,从干净 checkpoint 重新训练。
参考资料
这份笔记整理于 2026 年 10 月 17 日,10 月 18 日补充,模型开放情况与实验数字对应当时引用的报告和发布记录。论文原图均截自下列 arXiv PDF,每张图下方已标明图号。
HY-Embodied:0.5 论文 · VLM-1.0 论文 · GitHub · 权重 0.5 · 权重 1.0
其他:ACE-Brain-0.5 · OpenSpatial · RobotWorld · PLAN-Bench · GPT-6 Astra 报道(the-decoder)